Fireworks AI ปล่อย Ember-1 โมเดล Kimi K3 ปรับปรุงใหม่ ลดโทเคน 40%
Fireworks AI เปิดตัว Ember-1 รุ่นปรับฝึกเพิ่มจาก Kimi K3 ที่ประหยัดโทเคนประมาณ 40%
Fireworks AI เปิดตัว Ember-1 รุ่นปรับฝึกเพิ่มจาก Kimi K3 ที่ประหยัดโทเคนประมาณ 40%
นักวิจัยพบว่า LLM ที่ใช้ตัดสินคุณภาพ SQL ในระบบจริงต่างกับมนุษย์มาก จนต้องเปลี่ยนมาใช้โมเดล Qwen3.6-27B ที่ถูกกว่าและแม่นยำกว่า
นักวิจัยเสนอกรอบงาน HiCoMER จัดการหน่วยความจำทีมและบุคคลแบบลำดับชั้น พร้อมดึงข้อมูลที่ยังคงถูกต้อง…
วิจัยพบเซลล์ประสาทใน BERT ที่สำคัญต่อการตรวจจับข้อความ AI อยู่ไม่เกิน 1% ของทั้งหมด และสามารถใช้ได้กับโมเดลหลายประเภทโดยไม่ต้องระบุเซลล์ใหม่
นักวิจัยเสนอ HybridInfer ระบบเส้นทางแบบสามระดับ (อุปกรณ์-ขอบ-คลาวด์) ใช้ Q-learning ออฟไลน์ควบคุมด้วยหัวท่อนความร้อนและความซับซ้อนของคำถาม…
Google Research ได้นำเสนอ AI Video Co-Director ซึ่งเป็นระบบที่รวม 4 ระบบ Agentic Framework…
สรุปแนวโน้มของปี 2026 จาก speechclosing ของ WeAreDevelopers World Congress North America ในซานโฮเซ
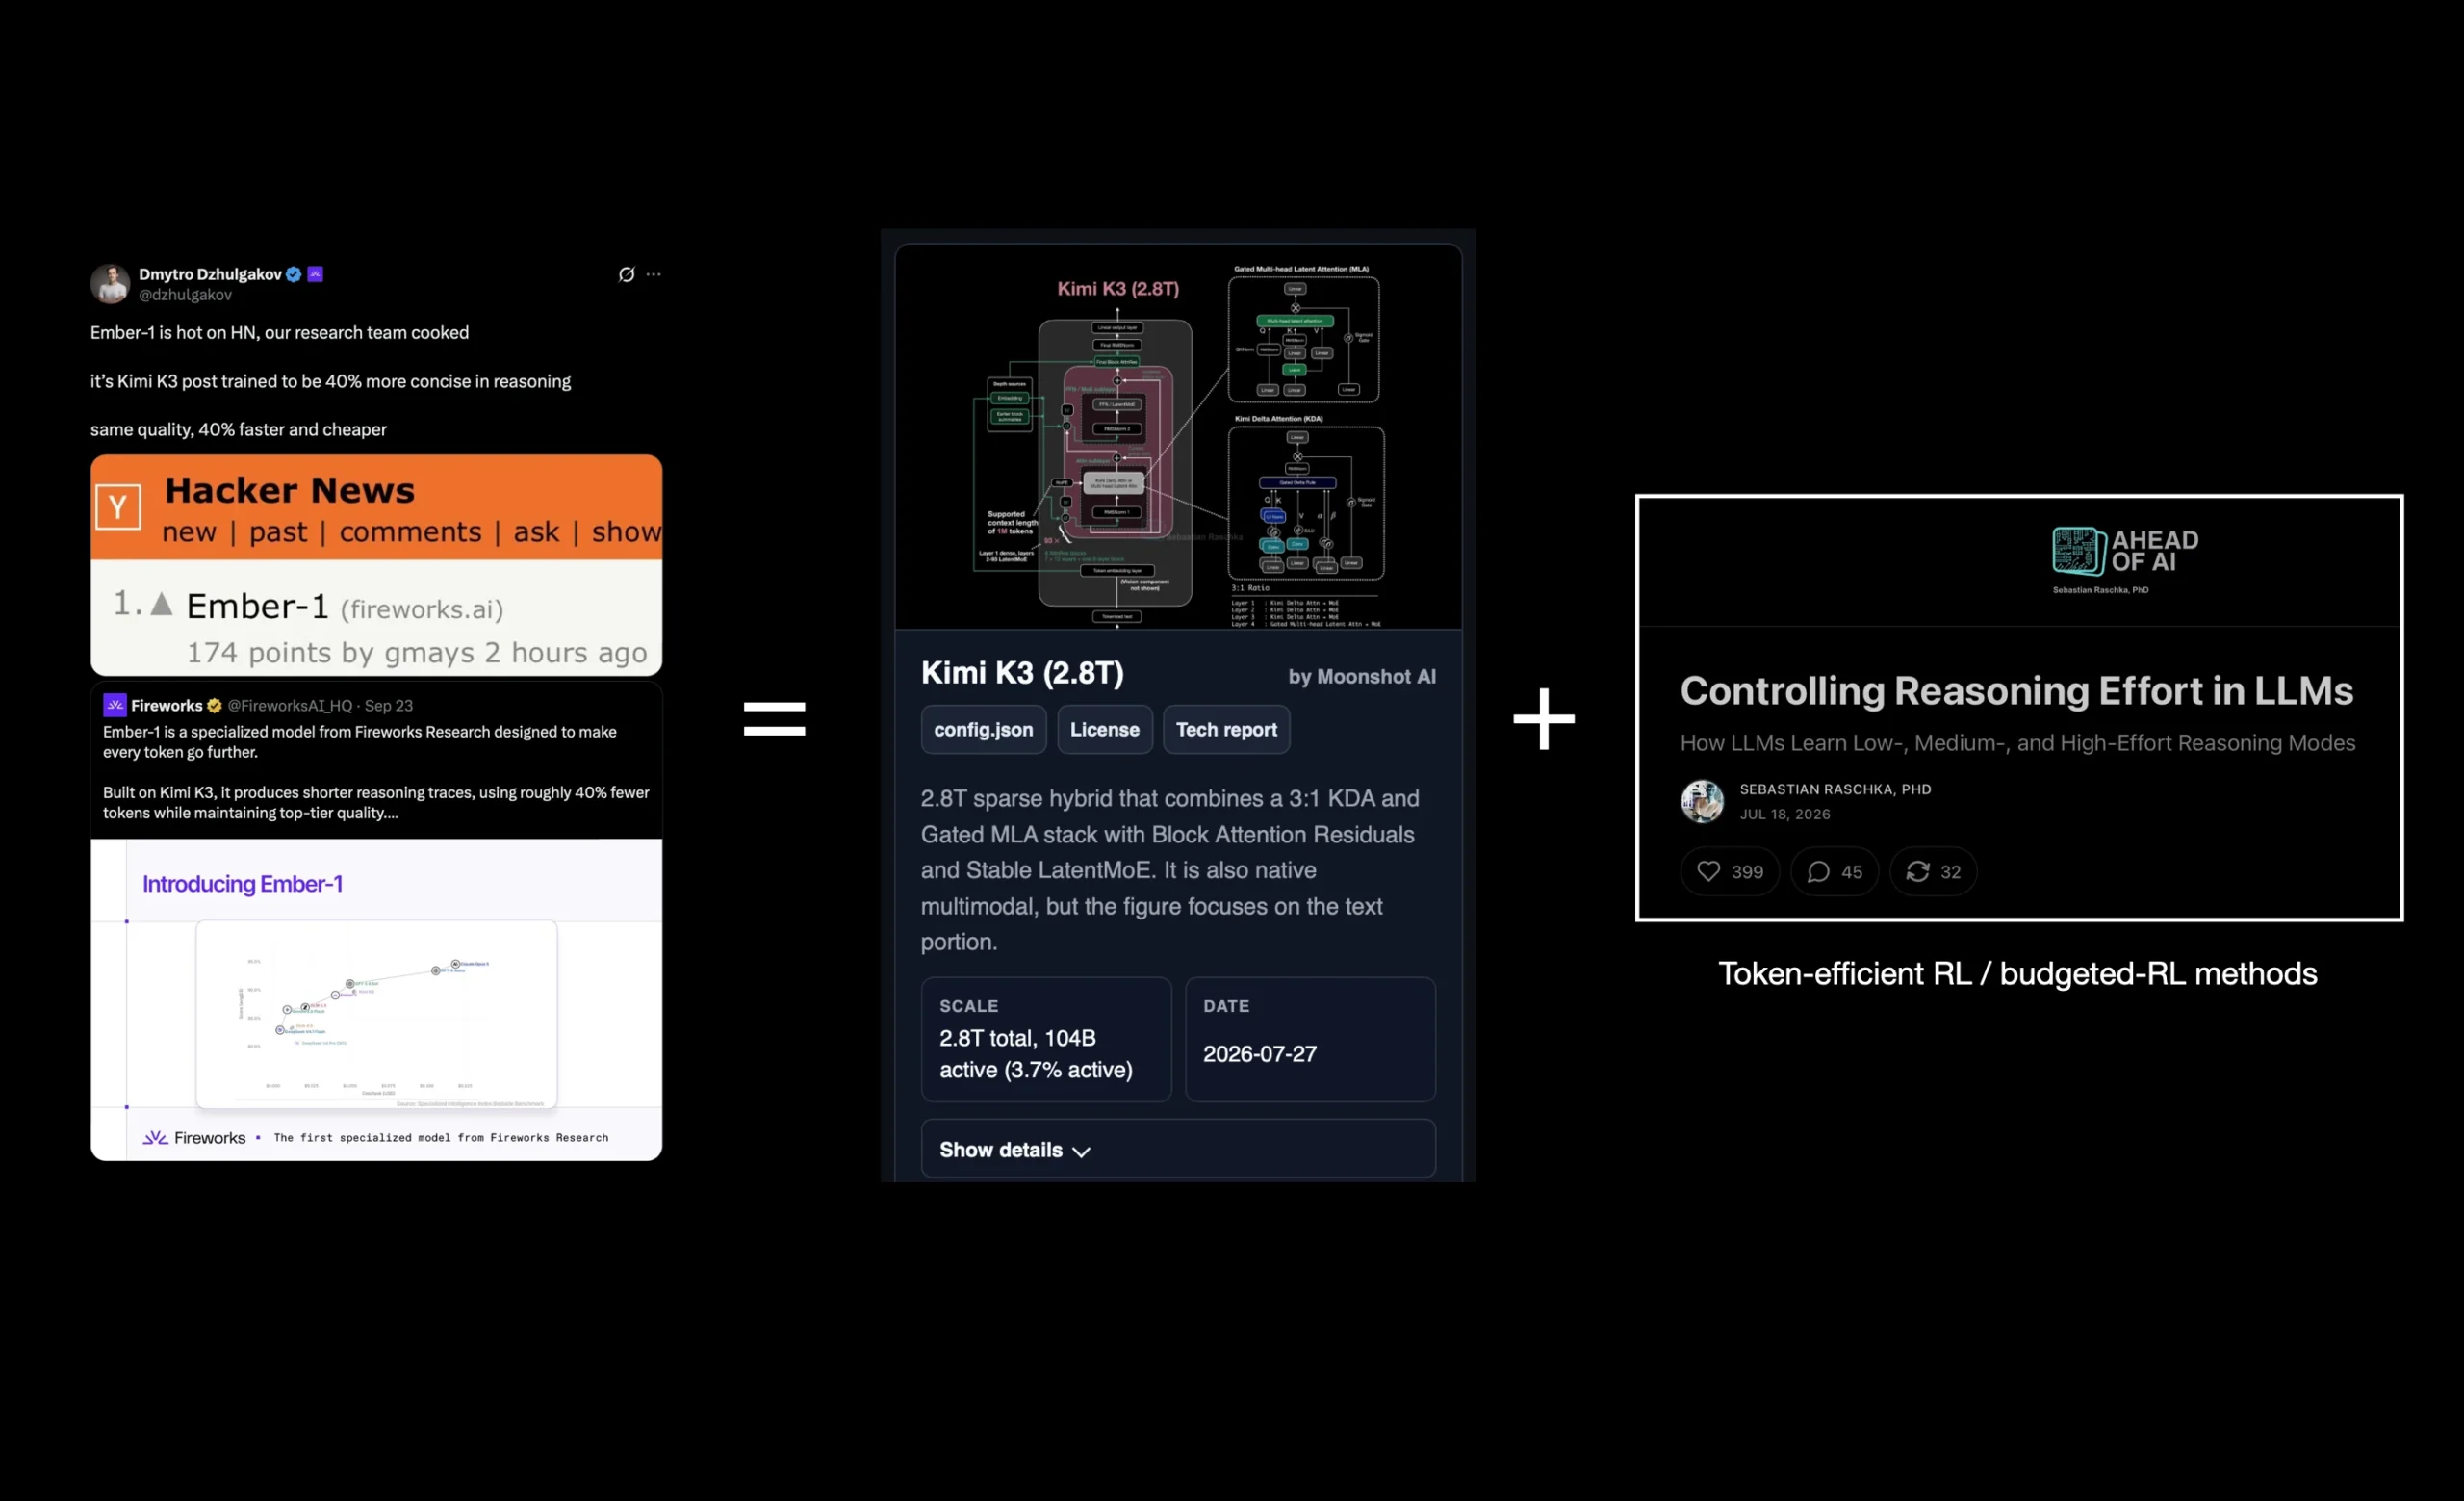
บทความนี้วิเคราะห์เหตุผลในการลงทุนใน LLM ที่ได้รับการ Post-Training โดยนำ Ember-1 ของ Fireworks เป็นตัวอย่าง ซึ่งใช้ตัวแปรทองคำน้อยลงประมาณ…
OpenAI ระบุว่าส่วนใหญ่ของทรัพยากรวิจัยปัจจุบันเน้นพัฒนารุ่น GPT-7 และรุ่นต่อๆ ไป
ทีมวิจัยมหาวิทยาลัยฟูดานวิเคราะห์บันทึกงาน 769 รายการ พบ AI agents เสนอวิธีการมาก แต่มนุษย์ยังคงเป็นผู้ตัดสินใจหลัก