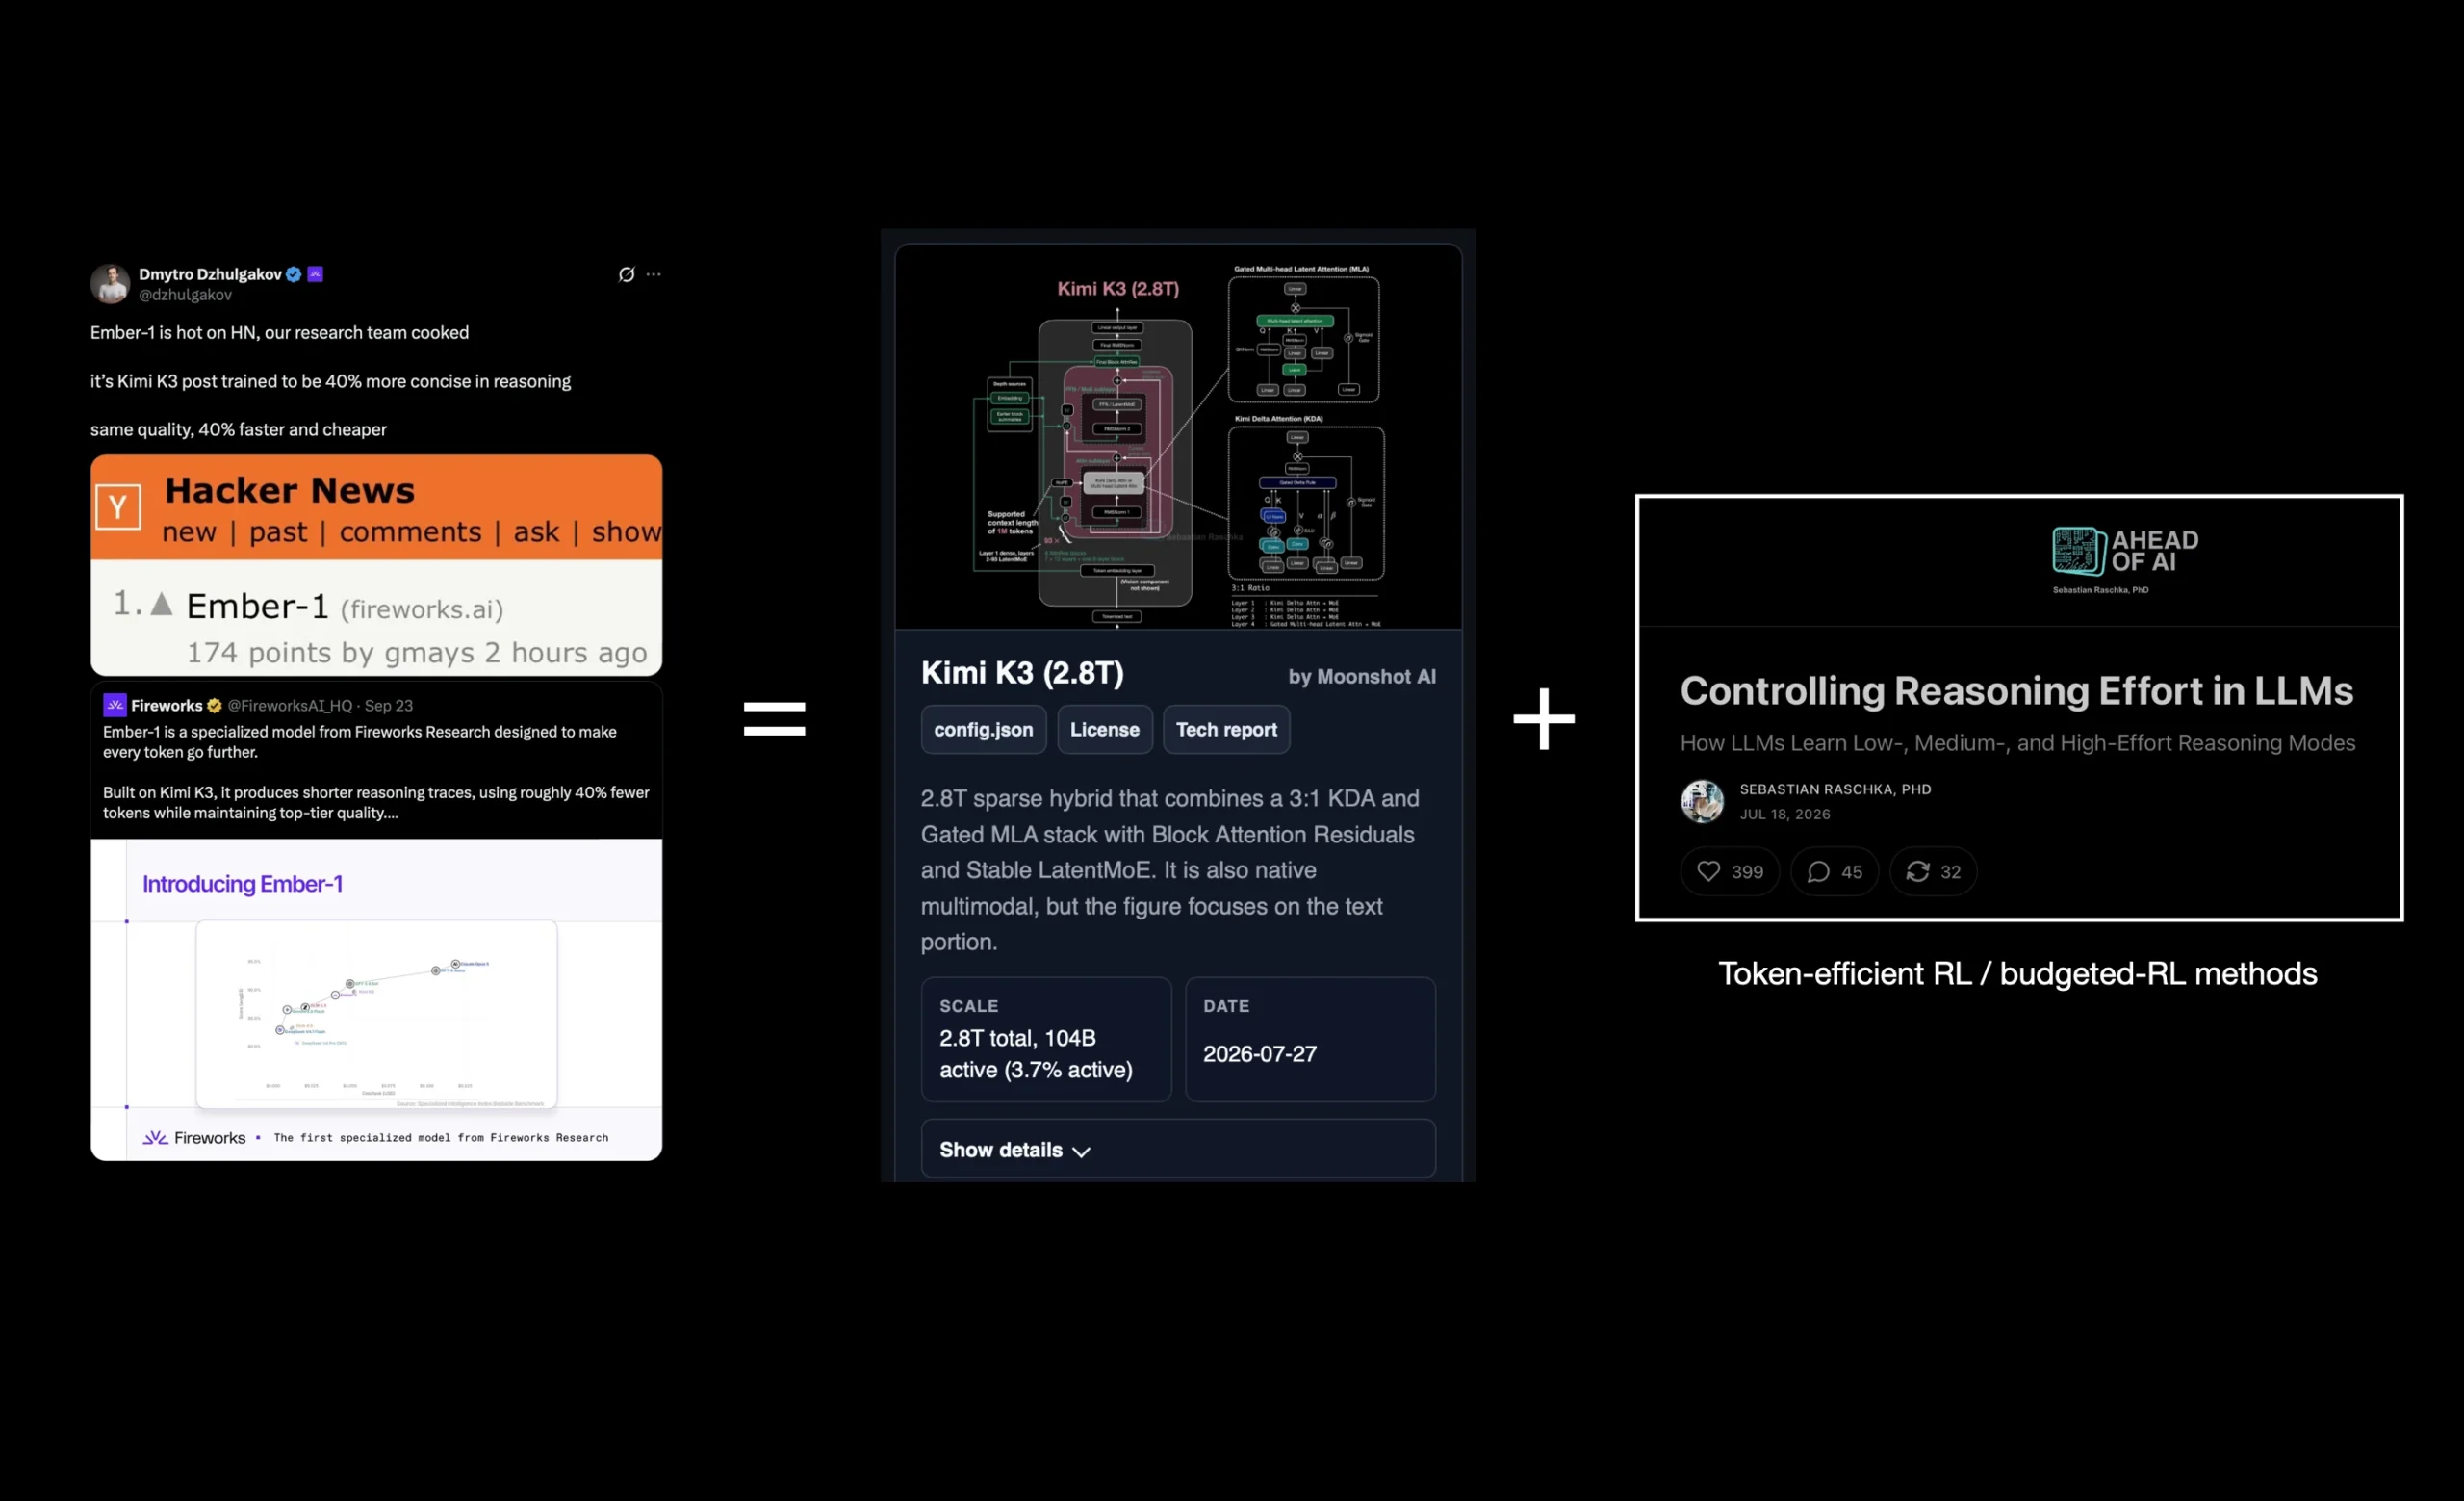
บทความนี้วิเคราะห์เหตุผลในการลงทุนใน LLM ที่ได้รับการ Post-Training โดยนำ Ember-1 ของ Fireworks เป็นตัวอย่าง ซึ่งใช้ตัวแปรทองคำน้อยลงประมาณ 40% ในขณะที่รักษาคุณภาพให้เท่าเดิม
ปัญหาหลักคือการฝึกสร้าง LLM ขั้นสู่จุดสูงสุด (500B พารามิเตอร์ขึ้นไป) มีค่าใช้จ่ายมหาศาล ทำให้ไม่มีเหตุผลในการทำซ้ำการฝึกซื้อต้นแบบ เมื่อมีโมเดลที่เปิดรับใช้โดยสาธารณะอยู่แล้ว
ผู้เขียนแนะนำให้เริ่มต้นด้วยโมเดลที่มีอยู่แล้วและใช้งบประมาณส่วนใหญ่ไปในการ Post-Training แทนที่จะใช้ทั้งเงินเพื่อฝึกซื้อต้นแบบใหม่
ตัวอย่าง Ember-1 แสดงให้เห็นถึงการพัฒนาที่เป็นรูปธรรม ซึ่งช่วยลดการใช้ตัวแปรทองคำลง 40% ได้โดยไม่สูญเสียความสามารถ
ศัพท์ที่ควรรู้
- Post-training – การปรับปรุงโมเดลหลังจากฝึกซื้อแล้ว
- Open-weight LLM – โมเดลที่เปิดรับใช้โดยสาธารณะ
- Token-efficient – การใช้ตัวแปรทองคำอย่างมีประสิทธิภาพ
- Frontier LLM – โมเดลระดับสูงสุดของ AI
- Pre-training – การฝึกซื้อต้นแบบจากข้อมูลขนาดใหญ่
ที่มา: sebastianraschka.com