Gemini 4 Carbon แข่ง Benchmark กับ Claude ชนะด้านความคุ้มค่า
SemiAnalysis ได้เผยแพร่ benchmark ใหม่คือ GDPx ซึ่งรวมคะแนนของ Gemini 4 Carbon ของ Google เข้าไปด้วย แม้ว่าคะแนนอาจจะตามหลัง Claude แต่…
SemiAnalysis ได้เผยแพร่ benchmark ใหม่คือ GDPx ซึ่งรวมคะแนนของ Gemini 4 Carbon ของ Google เข้าไปด้วย แม้ว่าคะแนนอาจจะตามหลัง Claude แต่…
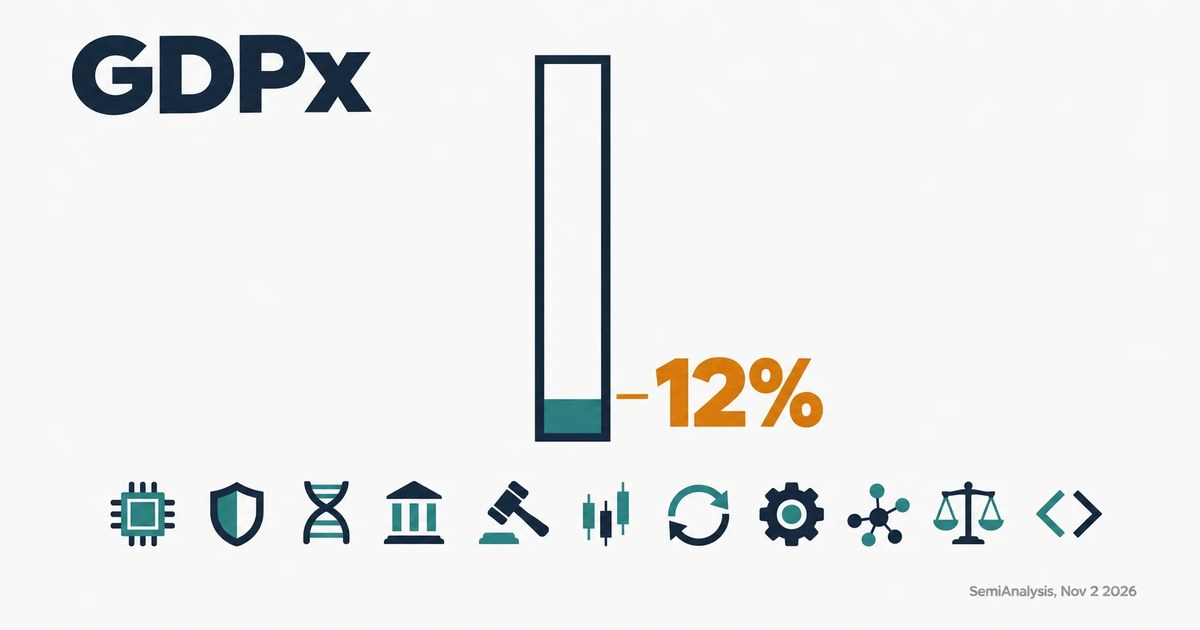
SemiAnalysis ได้เปิดตัว GDPx ซึ่งเป็นเกณฑ์มาตรฐานสำหรับ Agent Task โดยทดสอบโมเดล AI ต่างๆ ใน 11 โดเมน ด้วยงานที่ซับซ้อนเทียบเท่าการทำดีล…
OpenAI ได้เปิดเผยถึงการทดสอบ Benchmark ของ OpenAI Five ซึ่งเป็นระบบที่ผ่านการฝึกฝนอย่างต่อเนื่องและมีการปรับปรุงสถาปัตยกรรมเครือข่ายอย่างมาก…
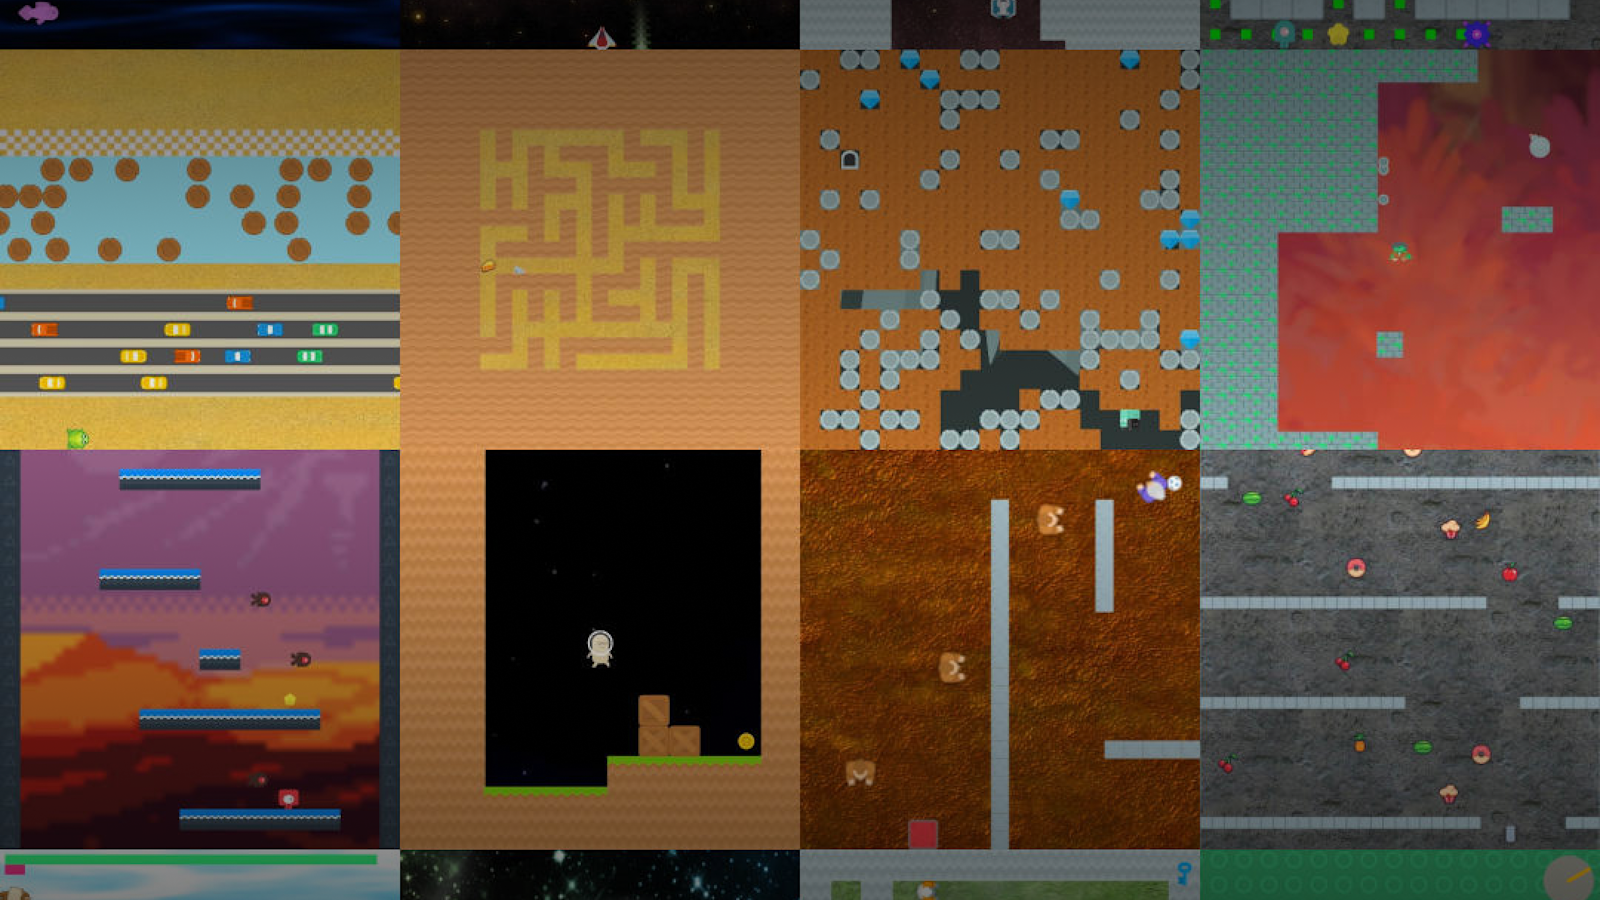
การทดลองในสภาพแวดล้อมต่างๆ พบว่า Agent สามารถเกิดภาวะ Overfit กับชุดข้อมูลการฝึกขนาดใหญ่ได้ ซึ่งเป็นข้อจำกัดของ Benchmark เก่าอย่าง Arcade…
OpenAI ได้เปิดตัว MLE-bench ซึ่งเป็นชุดทดสอบสำหรับวัดประสิทธิภาพของ AI agents ในด้านวิศวกรรมการเรียนรู้ของเครื่อง (ML engineering)…
OpenAI ได้เปิดตัว SWE-Lancer ซึ่งเป็นเกณฑ์มาตรฐานที่รวบรวมงานวิศวกรรมซอฟต์แวร์อิสระกว่า 1,400 งานจาก Upwork มูลค่ารวม 1 ล้านเหรียญสหรัฐฯ…
OpenAI ได้เปิดตัว PaperBench ซึ่งเป็นเกณฑ์มาตรฐานใหม่เพื่อประเมินความสามารถของ AI agents ในการจำลองงานวิจัย AI ที่ล้ำสมัย…
การทดสอบแสดงให้เห็นว่าการปรับใช้ GPT-5.6 Sol ในเกณฑ์มาตรฐาน ARC-AGI-3 นั้นสามารถทำคะแนนได้สูงขึ้นอย่างมากเมื่อมีการตั้งค่าบางอย่างถูกเปิดใช้…