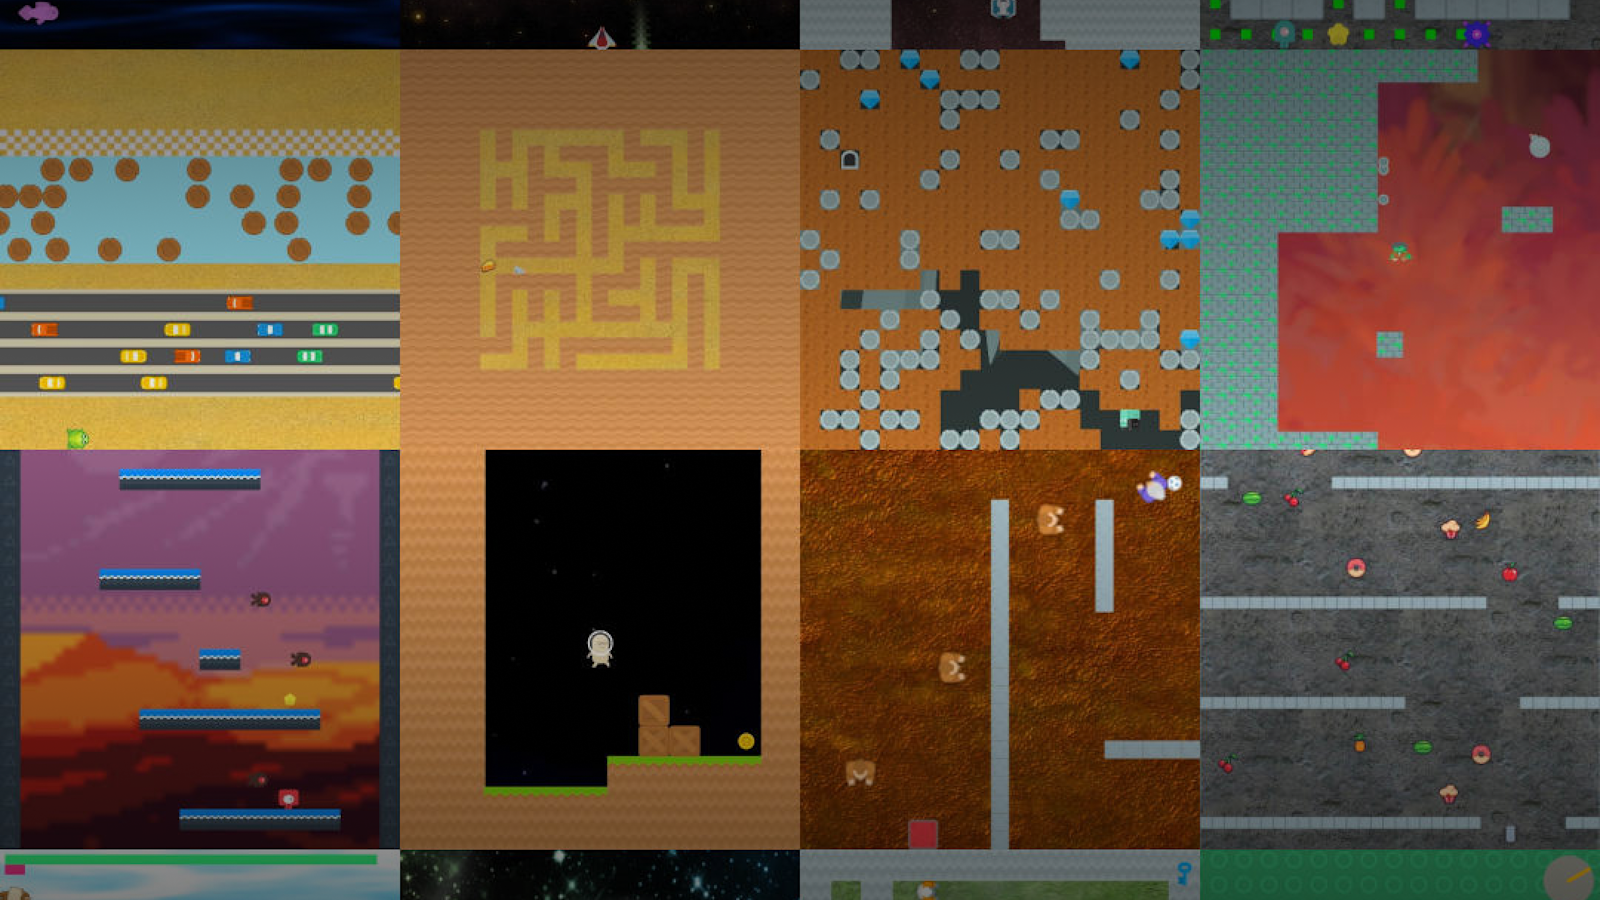
ในการทดลองหลายสภาพแวดล้อม พบว่า Agent สามารถเกิดภาวะ Overfit กับชุดข้อมูลการฝึกที่มีขนาดใหญ่มาก ซึ่งชี้ให้เห็นว่าการ Overfitting อาจมีอยู่ใน Benchmark แบบดั้งเดิมอย่าง Arcade Learning Environment (ALE) ซึ่งเป็นมาตรฐานทองคำใน Reinforcement Learning (RL) มานาน
แม้ว่าความหลากหลายของเกมใน ALE จะเป็นจุดแข็ง แต่การเน้นน้อยเรื่องการสรุปผล (Generalization) ถือเป็นข้อเสียสำคัญ ทำให้ต้องตั้งคำถามว่า Agent กำลังเรียนรู้ทักษะที่เกี่ยวข้องอย่างแข็งแกร่ง หรือเพียงแค่จดจำเส้นทางการเล่นเฉพาะเจาะจง
CoinRun ถูกสร้างขึ้นเพื่อตอบโจทย์นี้โดยเฉพาะ โดยใช้ Procedural Generation สร้างชุดระดับการฝึกและการทดสอบที่แตกต่างกัน ซึ่งเป็นแนวทางที่คล้ายคลึงกับงานก่อนหน้าอย่าง Obstacle Tower Challenge และ General Video Game AI framework
Procgen Benchmark นี้มุ่งเน้นไปที่ความสะดวกในการทดลอง ความหลากหลายสูงทั้งภายในและระหว่างสภาพแวดล้อม และยังพบแนวโน้มแปลกใหม่ว่าประสิทธิภาพการฝึกจะดีขึ้นเมื่อชุดข้อมูลการฝึกมีขนาดใหญ่เกินกว่าเกณฑ์ที่กำหนด ซึ่งต่างจาก Supervised Learning ที่ประสิทธิภาพมักลดลงตามขนาดชุดข้อมูล
ศัพท์ที่ควรรู้
- Arcade Learning Environment (ALE) – สภาพแวดล้อมเกมคลาสสิกที่ใช้เป็นมาตรฐานในการทดสอบ Reinforcement Learning (RL)
- Overfitting – สภาวะที่ Agent เรียนรู้และจดจำข้อมูลการฝึกมากเกินไปจนไม่สามารถนำไปใช้กับข้อมูลใหม่ได้
- Procedural Generation – กระบวนการสร้างเนื้อหา (เช่น ระดับเกม) ขึ้นมาใหม่โดยอัตโนมัติ แทนการใช้ชุดที่กำหนดไว้ตายตัว
- Generalization – ความสามารถของ Agent ในการนำทักษะที่เรียนรู้ไปประยุกต์ใช้กับสถานการณ์ใหม่ที่ไม่เคยเจอมาก่อน
ที่มา: OpenAI