
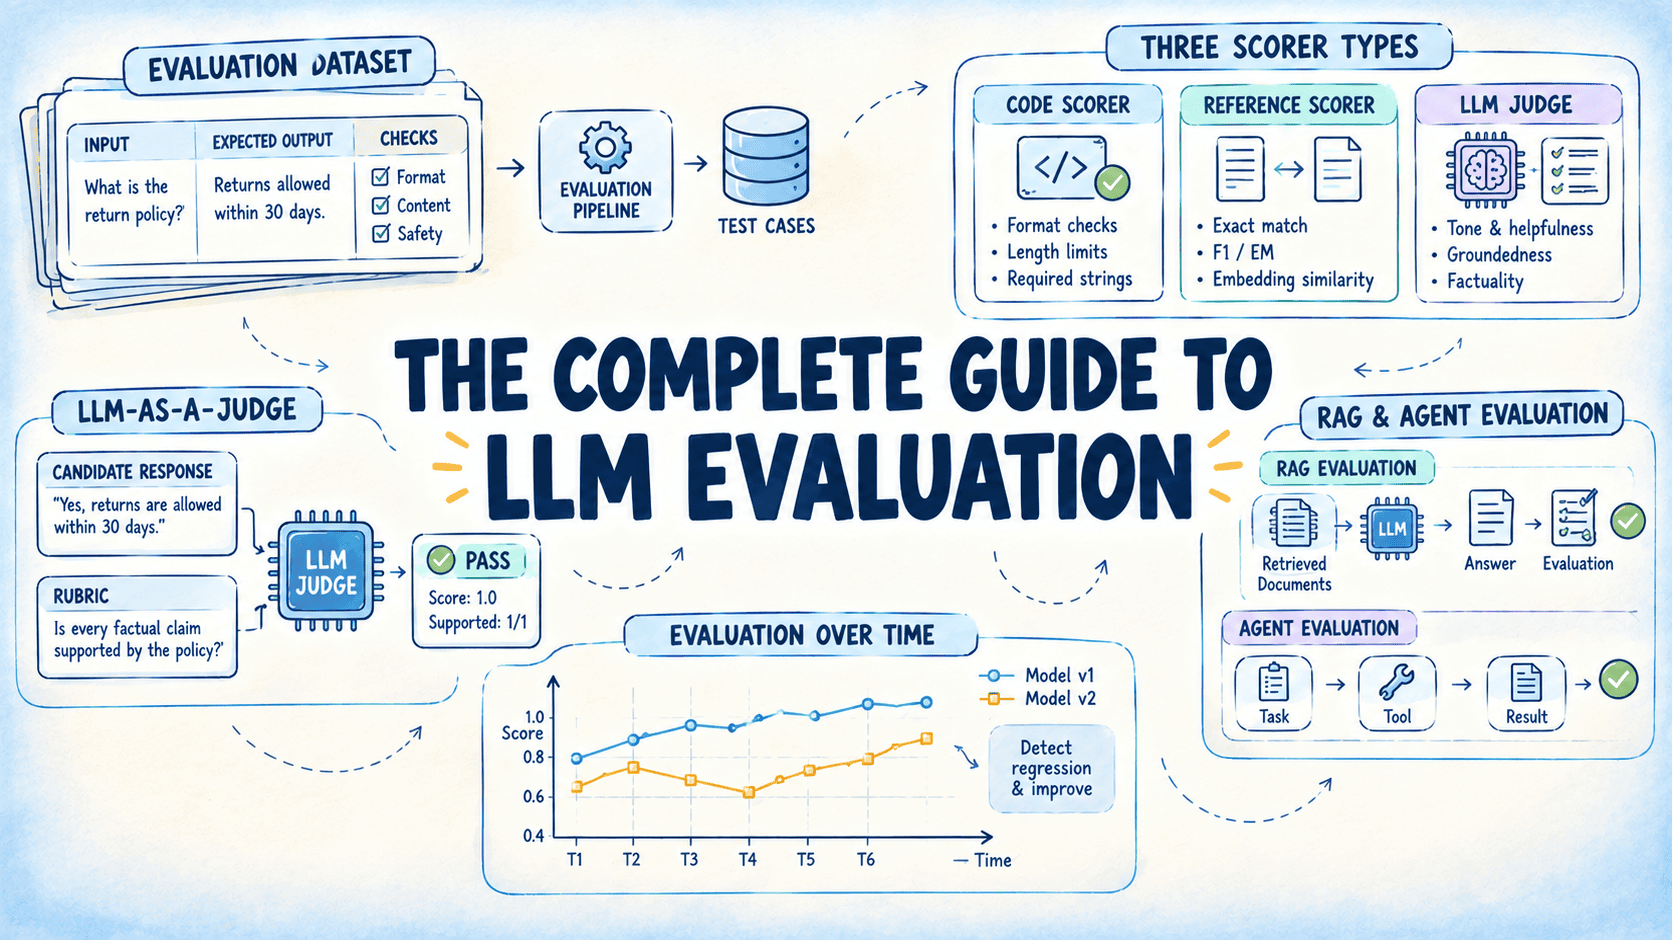
การทดสอบหน่วย (unit test) นั้นตรวจสอบความเท่ากัน แต่ในโลกของภาษาธรรมชาติ การเปรียบเทียบสตริงอาจไม่สามารถตัดสินได้ว่าข้อความสองชุดมีความหมายเดียวกัน เช่น “สามารถคืนสินค้าได้ภายใน 30 วัน” กับ “รับคืนสินค้าภายในหนึ่งเดือนหลังการจัดส่ง”
สำหรับการเลือกตัววัด (Scorers) เช่น BERTScore นั้นสามารถจัดการกับการใช้คำพ้องผ่าน Cosine similarity ระหว่าง token embeddings ได้ แต่ยังขาดการตัดสินเรื่องน้ำเสียงหรือการสนับสนุนข้อกล่าวอ้างจากแหล่งข้อมูล
การประเมินขั้นสูงสามารถทำได้โดยการใช้ prompt สำหรับการสร้างคำตอบ (generation prompt) เพื่อให้ LLM ให้คะแนนจาก 1 ถึง 5 หรือ 0 ถึง 10 โดยใช้การถ่วงน้ำหนักความน่าจะเป็นของ output tokens เพื่อให้ได้ผลลัพธ์ที่เสถียร
เมื่อทำการเปรียบเทียบแบบคู่ (pairwise comparisons) จำเป็นต้องมีการทดสอบว่าการตัดสินใจนั้นมีความสอดคล้องกันเมื่อสลับลำดับการเปรียบเทียบหรือไม่
ในการประเมินตลอดวงจรการใช้งาน ควรสร้างชุดกรณีทดสอบจำนวน 25 ถึง 50 กรณี ซึ่งครอบคลุมทั้งคำขอปกติ กรณีขอบเขต (edge cases) ข้อมูลที่อาจถูกโจมตี (adversarial inputs) และคำถามนอกเรื่องที่บอทควรปฏิเสธ
ศัพท์ที่ควรรู้
- LLM (Large Language Model) – คือแบบจำลองภาษาขนาดใหญ่ที่ใช้ในการประมวลผลภาษาธรรมชาติ BERTScore – เป็นตัววัดที่ใช้การฝังคำ (embedding) เพื่อเปรียบเทียบความคล้ายคลึงกันของข้อความที่ใช้คำต่างกันแต่สื่อความหมายเดียวกัน Cosine similarity – คือการวัดทางคณิตศาสตร์ที่ใช้เปรียบเทียบว่าเวกเตอร์สองตัวมีความใกล้เคียงกันในทิศทางมากน้อยเพียงใด RAG – คือระบบที่ช่วยให้ LLM สามารถดึงข้อมูลจากฐานความรู้ภายนอกมาใช้ในการตอบคำถามได้ Agent – คือระบบอัตโนมัติที่สามารถทำงานหลายขั้นตอนเพื่อบรรลุเป้าหมายที่ซับซ้อนได้
ที่มา: machinelearningmastery.com