
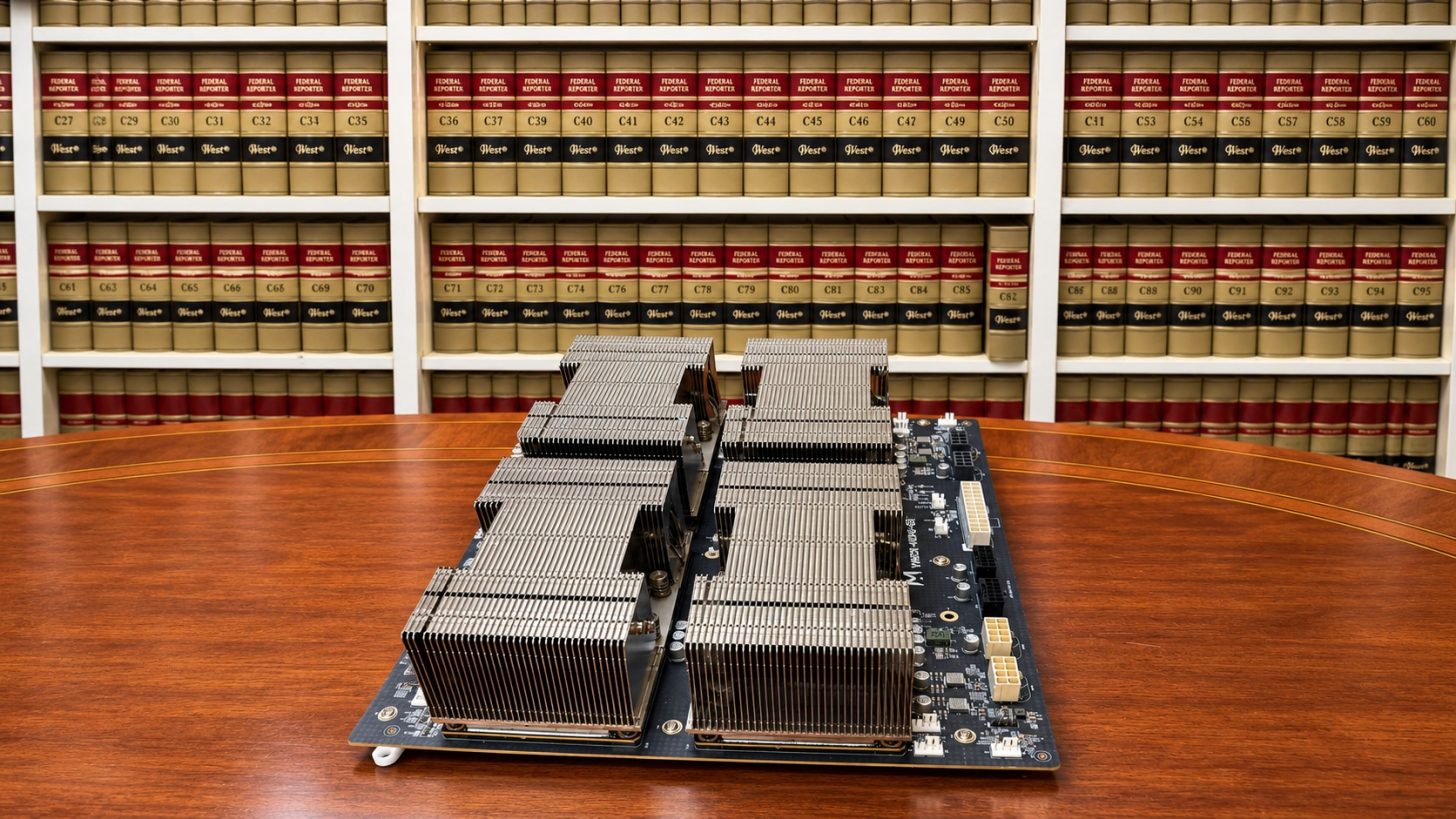
แปด NVIDIA V100 GPUs ให้ 256 GB HBM2 สำหรับการอนุมาน AI ในเครื่อง
NVIDIA Tesla V100 SXM2 ซึ่งใช้สถาปัตยกรรม Volta มีหน่วยความจำ HBM2 สูงถึง 32 GB ต่อตัว และรองรับ NVLink ทำให้การ์ดจอระดับองค์กรเก่าเหล่านี้ยังคงมีความสามารถในการรันโมเดล AI ขนาดใหญ่ในเครื่องได้
การประกอบชุดนี้เริ่มต้นด้วยการประเมินว่าการ์ดจอแต่ละตัวมีต้นทุนประมาณ $2,400 ทำให้ชุดเร่งความเร็วรวมอยู่ที่ประมาณ $4,800 ไม่รวมส่วนประกอบอื่นๆ
การอัปเกรดใหม่ปรับปรุงความเที่ยงตรงของ AI โดยแลกกับประสิทธิภาพ
การปรับปรุงล่าสุดที่เรียกว่า Volta Max uPLift ได้อัปเกรฆูรุสต์ที่ใช้งานบ่อยให้ใช้ความแม่นยำระดับ NVFP4 ของ NVIDIA ในขณะที่ยังคงใช้การแทนค่าแบบ 2-bit สำหรับส่วนที่เหลือ
แม้ว่าโครงการนี้จะประสบปัญหา เช่น ขั้วต่อไฟไหม้ ข้อผิดพลาดของ ECC memory และการขัดข้อง ซึ่งคาดว่าเกี่ยวข้องกับการจ่ายไฟที่ไม่เสถียร แต่ผู้สร้างประเมินว่าการตั้งค่าส่วนตัวนี้สามารถทดแทนเวิร์กโฟลว์ LLM เดิมได้ถึง 50–60%
ศัพท์ที่ควรรู้
- NVIDIA Tesla V100 – การ์ดจอระดับองค์กรที่ใช้ในเซิร์ฟเวอร์ ซึ่งเป็นส่วนประกอบสำคัญในการประมวลผล AI
- DeepSeek V4.1-Flash – โมเดลภาษาขนาดใหญ่ (LLM) ที่ถูกนำมาใช้งานในเครื่องของเซิร์ฟเวอร์
- HBM2 – ชนิดของหน่วยความจำที่มีความเร็วสูงมาก ถูกติดตั้งอยู่บนการ์ดจอ เพื่อให้การประมวลผล AI เป็นไปอย่างรวดเร็ว
- Quantization – กระบวนการลดความละเอียดของข้อมูลโมเดล เพื่อให้สามารถรันบนฮาร์ดแวร์ที่มีข้อจำกัดได้
ที่มา: Wccftech