
การปรับแต่งโมเดลภาษาขนาดใหญ่ (LLM) ให้เข้ากับงานเฉพาะทางนั้นสามารถทำได้โดยไม่ต้องเข้าไปแก้ไขน้ำหนัก (weight) ของโมเดลหลักเลย ซึ่งการใช้ Prompt engineering, few-shot examples หรือ retrieval-augmented generation ก็สามารถกำหนดผลลัพธ์ของโมเดลได้เช่นกัน
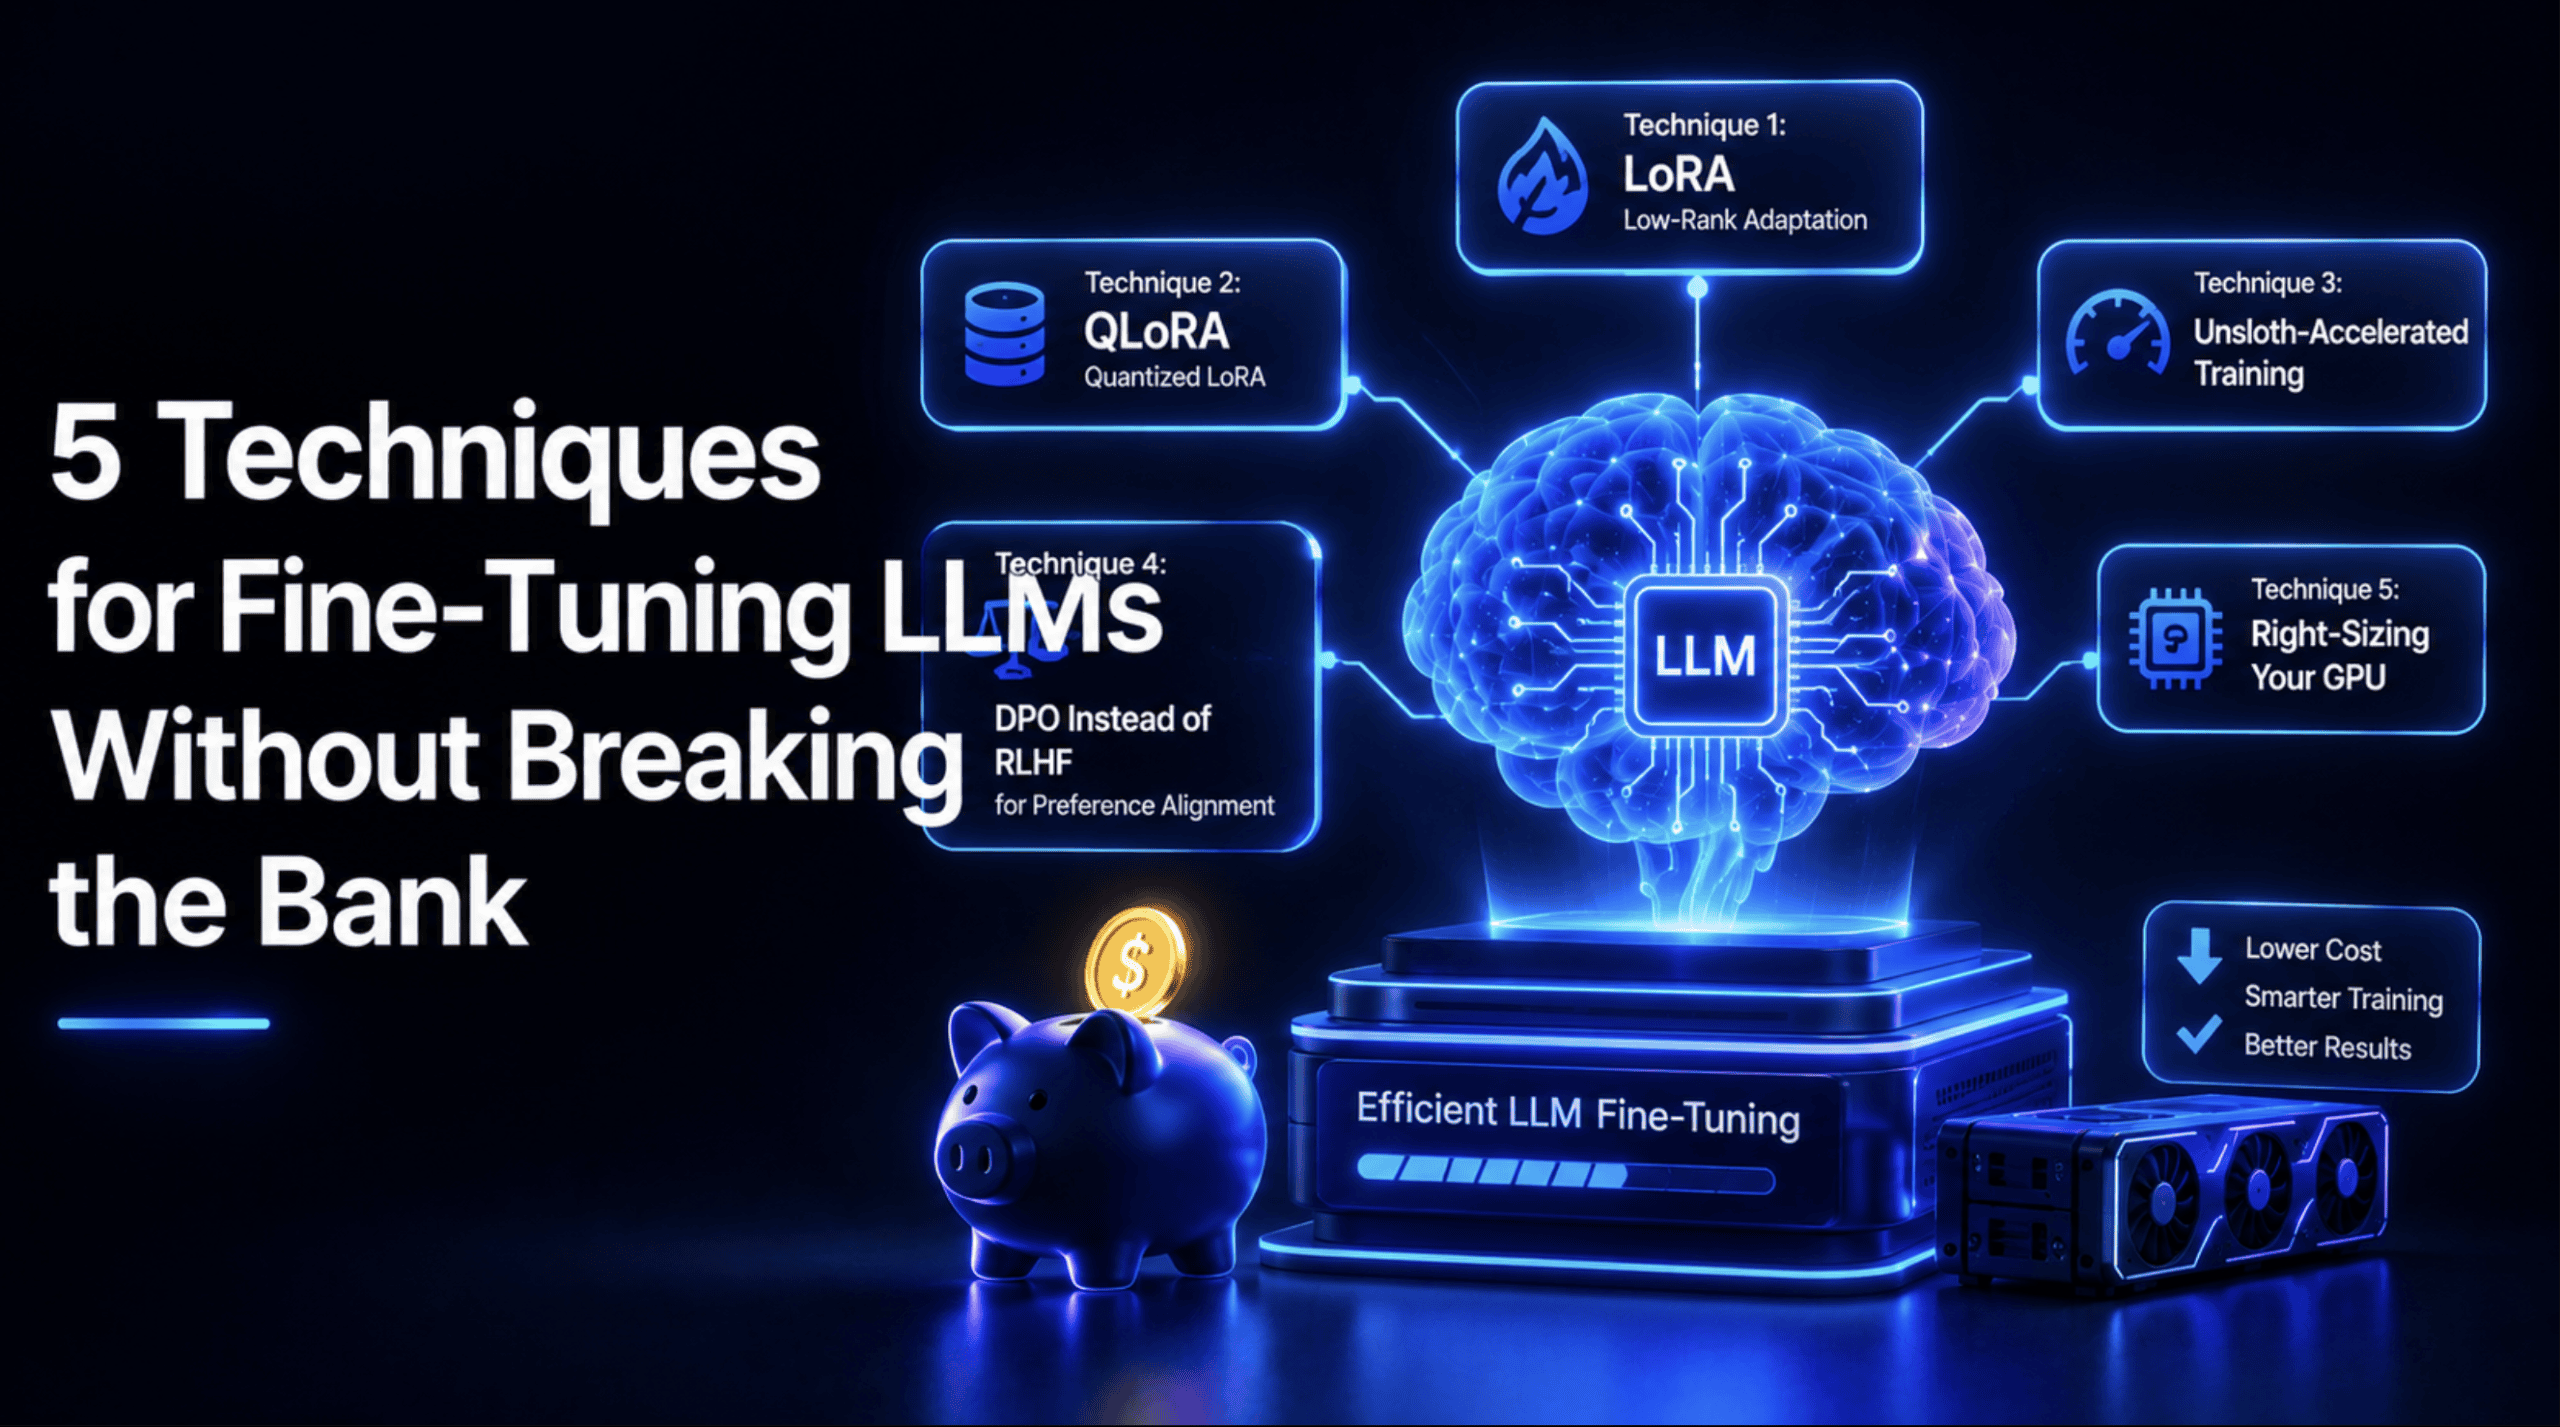
สำหรับเทคนิคที่ต้องปรับน้ำหนักโมเดลนั้น Low-Rank Adaptation (LoRA) อาศัยสมมติฐานว่าการเปลี่ยนแปลงน้ำหนักที่จำเป็นต่อการปรับโมเดลให้เข้ากับงานใหม่นั้นมีอันดับภายใน (intrinsic rank) ต่ำ ทำให้สามารถใช้พารามิเตอร์จำนวนน้อยมากในการจับรูปแบบที่ต้องการได้
ในส่วนของ Quantized Low-Rank Adaptation ซึ่งถูกนำเสนอในปี 2023 นั้น จะทำการทำให้โมเดลพื้นฐาน (base model) ที่ถูกแช่แข็ง (frozen) มีความแม่นยำลงเหลือเพียง 4-bit NormalFloat ขณะที่ตัว LoRA adapter ยังคงรักษาความแม่นยำไว้สูง ทำให้ประหยัดการใช้หน่วยความจำไปได้เกือบสี่เท่าโดยแทบไม่สูญเสียคุณภาพในงานส่วนใหญ่
เทคนิคเหล่านี้ช่วยให้การปรับจูนโมเดลมีความคุ้มค่าและเข้าถึงได้มากขึ้นอย่างเห็นได้ชัด
ศัพท์ที่ควรรู้
- LLM – Large Language Model คือโมเดลภาษาขนาดใหญ่ที่ใช้ในการประมวลผลและสร้างข้อความ
- Prompt engineering – คือการออกแบบคำสั่งหรือข้อความนำเข้าเพื่อให้โมเดลสร้างผลลัพธ์ที่ต้องการ
- Low-Rank Adaptation – เป็นเทคนิคที่ปรับเฉพาะส่วนเล็กๆ ของโมเดลโดยใช้พารามิเตอร์น้อยมากในการปรับให้เข้ากับงานใหม่
- Quantized Low-Rank Adaptation – คือการใช้ LoRA ร่วมกับการลดความแม่นยำของโมเดลพื้นฐานลงเหลือ 4-bit เพื่อประหยัดหน่วยความจำ
ที่มา: kdnuggets.com