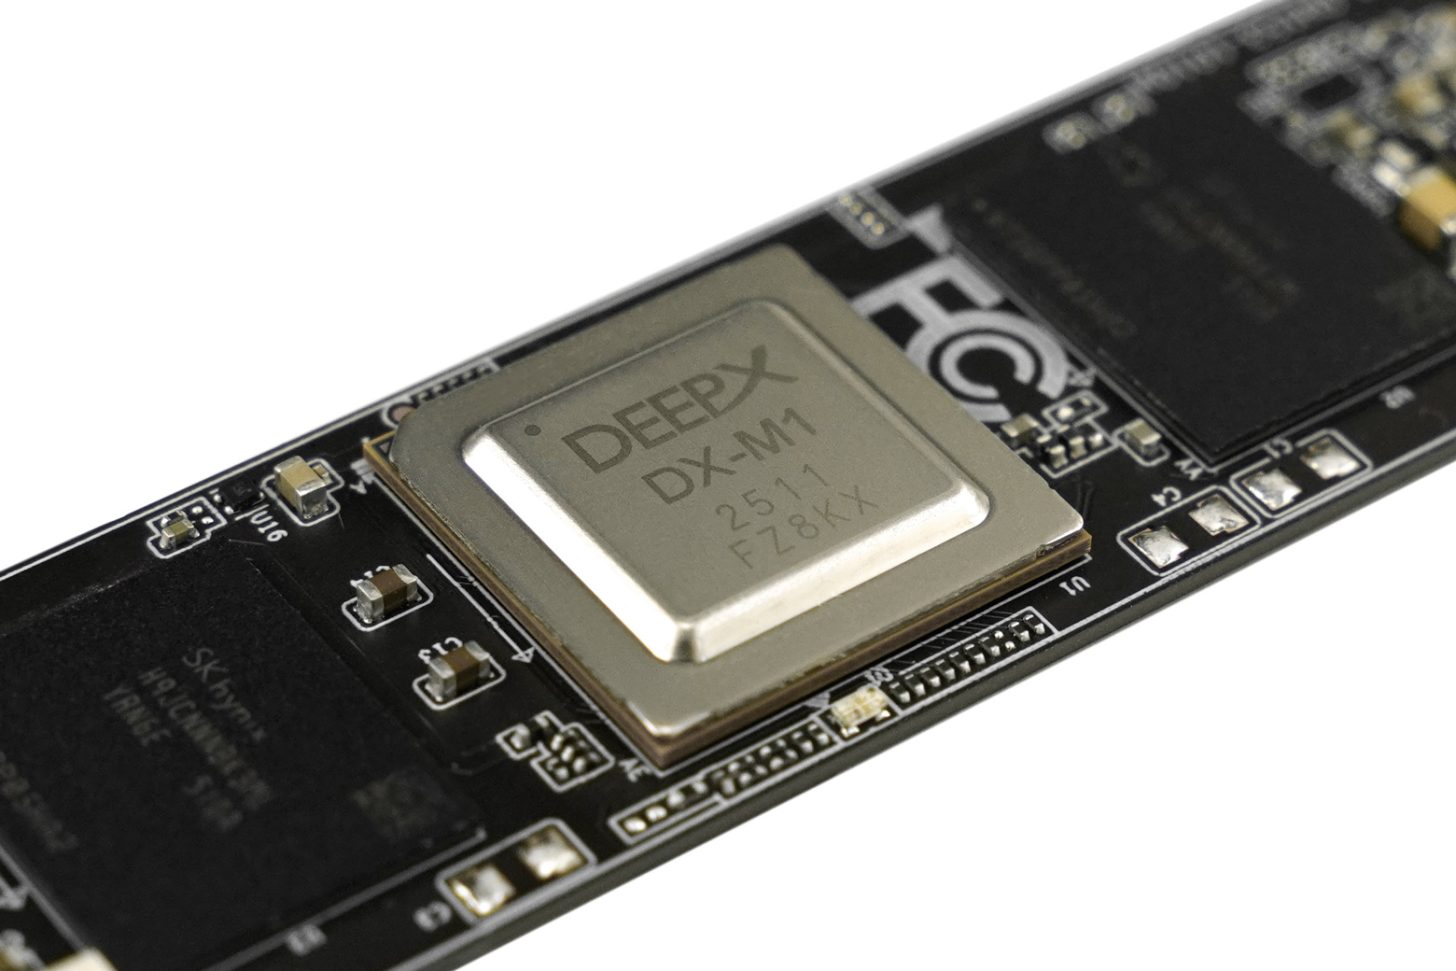
DX-M1 เป็น Inference Accelerator โดยเฉพาะ ไม่คาดหวังรันโมเดล AI ขนาดใหญ่ด้วย RAM 4GB
แม้จะมีขนาดเท่ากับ PCIe NVMe Gen 5 SSD แต่โมดูล AI Accelerator นี้ให้การคำนวณ INT8 ได้ถึง 25 TOPS โดยใช้พลังงานเพียง 2-5W ซึ่งเหมาะกับการใช้งานใน Mobile Robotics หรือระบบขนาดกะทัดรัด
ฮาร์ดแวร์นี้ใช้ RAM บนบอร์ด 4GB LPDDR5 สำหรับโหลดน้ำหนักเครือข่ายประสาท และมี QSPI NAND Flash 1Tbit สำหรับเฟิร์มแวร์และโมเดลที่คอมไพล์แล้ว การสื่อสารทั้งหมดผ่าน PCIe Gen 3 และรองรับ PyTorch, TensorFlow, TensorFlow Lite, และ ONNX ผ่าน DXNN SDK
อย่างไรก็ตาม โมดูลนี้ถูกออกแบบมาเพื่อเป็น Inference Accelerator สำหรับงานเฉพาะทาง เช่น การวิเคราะห์วิดีโอแบบเรียลไทม์ และไม่สามารถใช้สำหรับฝึกโมเดล Machine Learning หรือรัน Large Language Models ขนาด 70B ได้
อีกข้อจำกัดคือไม่สามารถใช้พื้นที่เก็บข้อมูลบนบอร์ดสำหรับระบบปฏิบัติการหลักได้ หากติดตั้งใน M.2 slot ว่างเปล่า จึงอาจพลาดโอกาสในการอัปเกรดด้วย NVMe drive มาตรฐาน
แต่สำหรับผู้ที่สนใจและนักพัฒนาที่รันฟีดกล้องอัตโนมัติ หรือหุ่นยนต์แบบ Localized โดยไม่ต้องการใช้พลังงานสูงของ GPU บน Workstation นั้น โมดูลราคา $139 นี้ถือเป็นทางเลือกที่ดีเยี่ยม
ศัพท์ที่ควรรู้
- AI Accelerator – อุปกรณ์ที่ช่วยเร่งการทำงานของปัญญาประดิษฐ์ให้เร็วขึ้น
- TOPS – หน่วยวัดประสิทธิภาพการประมวลผลของ AI ที่บ่งบอกจำนวนการคำนวณต่อวินาที
- Inference Accelerator – ส่วนประกอบที่ถูกออกแบบมาเพื่อรันโมเดล AI ที่ผ่านการฝึกแล้ว (อนุมาน) โดยเฉพาะ
- LPDDR5 RAM – ชนิดของหน่วยความจำที่ใช้ในอุปกรณ์พกพา ซึ่งในที่นี้ใช้สำหรับโหลดน้ำหนักโมเดล AI
- PCIe Gen 3 – อินเทอร์เฟซมาตรฐานที่ใช้ในการเชื่อมต่อโมดูลนี้เข้ากับคอมพิวเตอร์
ที่มา: Wccftech