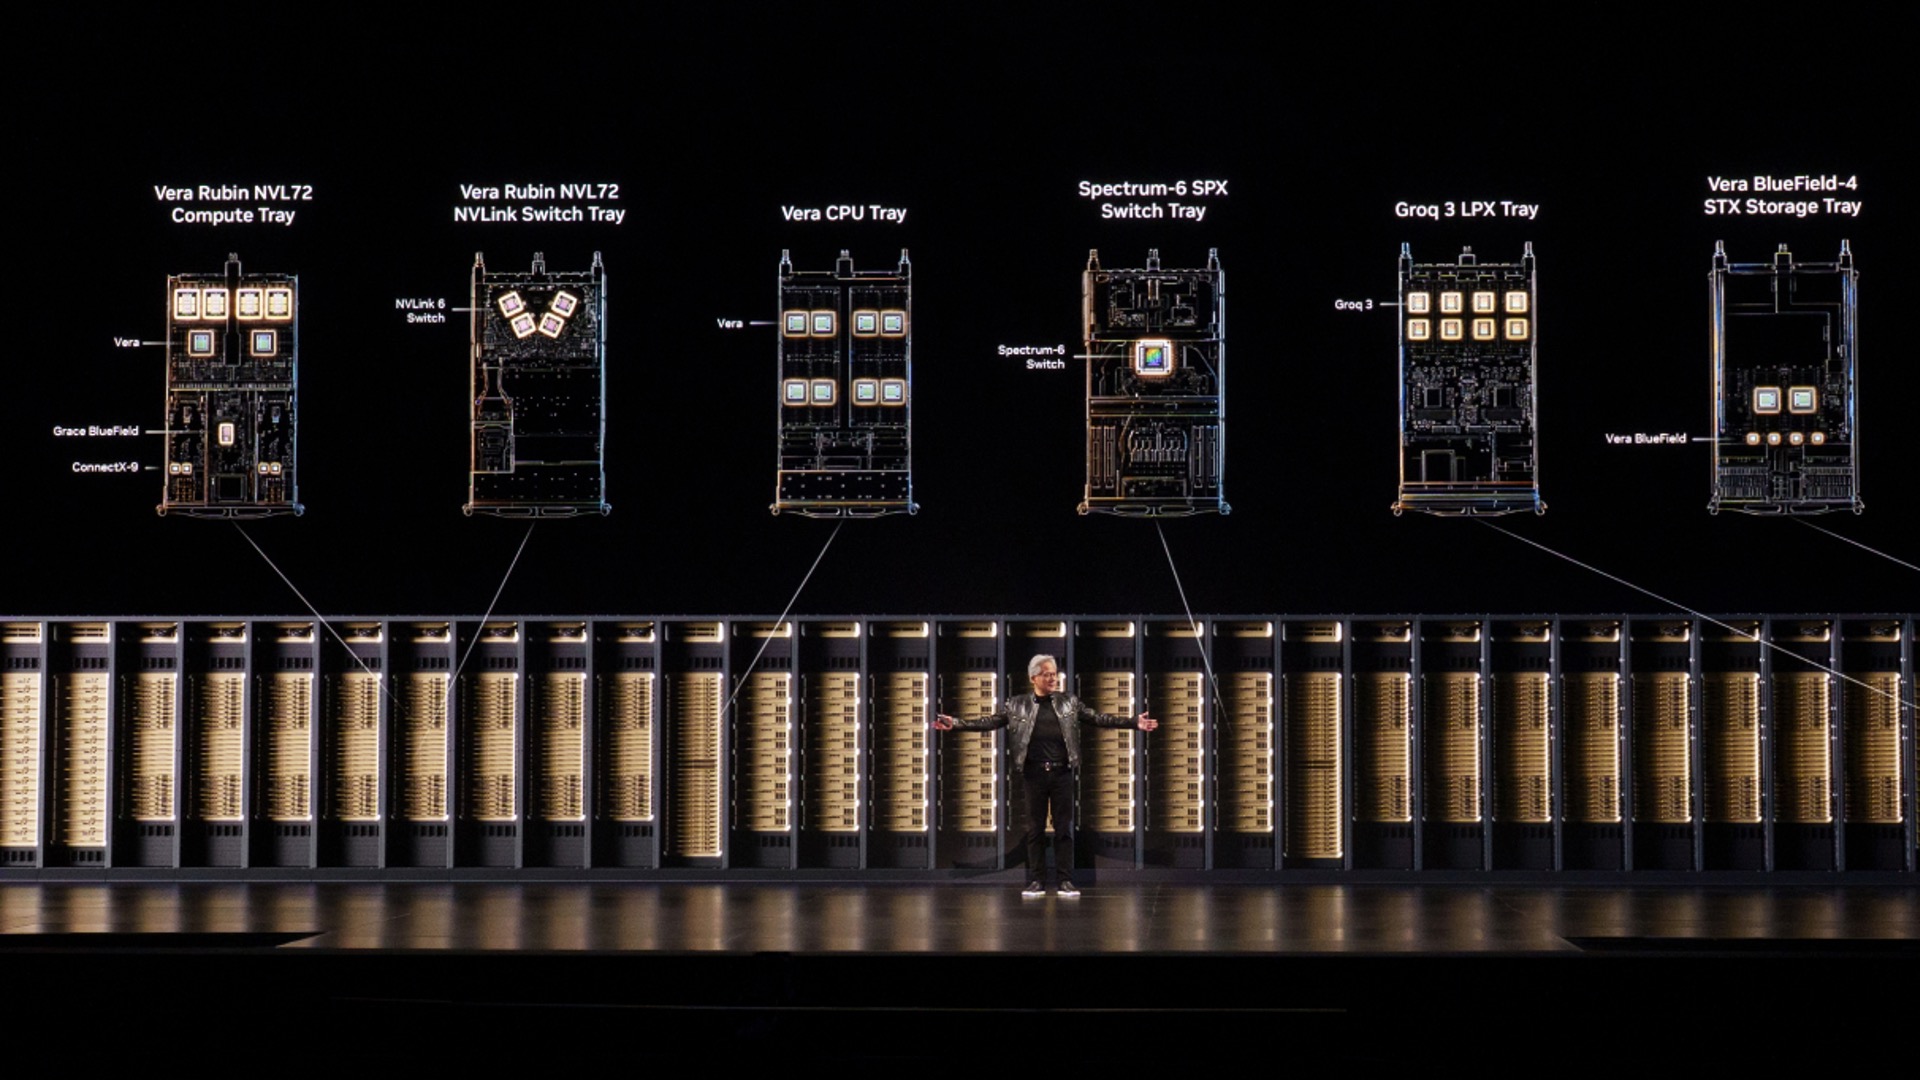
โมเดลล่าสุดหลายตัว เช่น FLUX.2 [klein] จาก Black Forest Labs, Inkling จาก Thinking Machines Lab, Beam 1.0 จาก Reflection, Meta Muse Spark จาก Meta, Step 5 Preview จาก StepFun และ NVIDIA Nemotron 3.5 Super VL ต่างก็เปิดตัวพร้อมจุดตรวจสอบ NVFP4 ซึ่งแสดงให้เห็นการนำเทคนิคความแม่นยำ 4-bit มาใช้ในการอนุมานที่เร็วและประหยัดหน่วยความจำมากขึ้น
การดำเนินการเครื่องมือที่รวดเร็วช่วยลดระยะเวลาที่ KV cache ไม่ทำงานระหว่างการเรียกใช้เครื่องมือ และหน่วยความจำ LPDDR ขนาดใหญ่ที่เชื่อมต่อกับ NVIDIA Rubin GPUs ผ่าน NVIDIA NVLink-C2C ช่วยให้บริบทที่หยุดชั่วคราวมีที่พักและกลับมาได้อย่างรวดเร็ว
ต่างจาก local SSD, NVIDIA CMX นั้นใช้ร่วมกันในเซิร์ฟเวอร์ และต่างจาก enterprise storage ตรงที่มันข้ามค่าใช้จ่ายในการป้องกันข้อมูลระยะยาวที่ไม่จำเป็นสำหรับบริบทที่มีอายุสั้น
สำหรับด้านประสิทธิภาพ ในเวิร์กโหลด SemiAnalysis AgentX DeepSeek V4 Pro, NVIDIA GB300 NVL72 ให้ Throughput สูงกว่าแพลตฟอร์ม NVIDIA H200 ถึง 10 เท่าต่อดอลลาร์ ที่อัตรา 100 tokens ต่อวินาทีต่อผู้ใช้ โดยมีศักยภาพของ HBM ต่อ GPU เพิ่มขึ้นเกือบสองเท่า
ศัพท์ที่ควรรู้
- GPU – หน่วยประมวลผลกราฟิก (Graphics Processing Unit) คือชิปที่ใช้ในการประมวลผลคำนวณจำนวนมากอย่างรวดเร็ว
- Full-Stack Codesign – การออกแบบร่วมแบบครบวงจรคือการทำงานร่วมกันของซอฟต์แวร์และฮาร์ดแวร์ทั้งหมดเพื่อประสิทธิภาพสูงสุด
- 4-bit precision – ความแม่นยำ 4-bit คือการใช้จำนวนบิตที่น้อยลงในการแทนค่า ทำให้ประหยัดหน่วยความจำในการรันโมเดล
- KV cache – คือหน่วยความจำที่เก็บข้อมูลบริบทที่ใช้ในการอนุมานของโมเดล เพื่อให้การประมวลผลครั้งต่อไปเร็วขึ้น
- Throughput – คือปริมาณงานที่ระบบสามารถประมวลผลได้สำเร็จในหนึ่งหน่วยเวลา
ที่มา: NVIDIA Blog