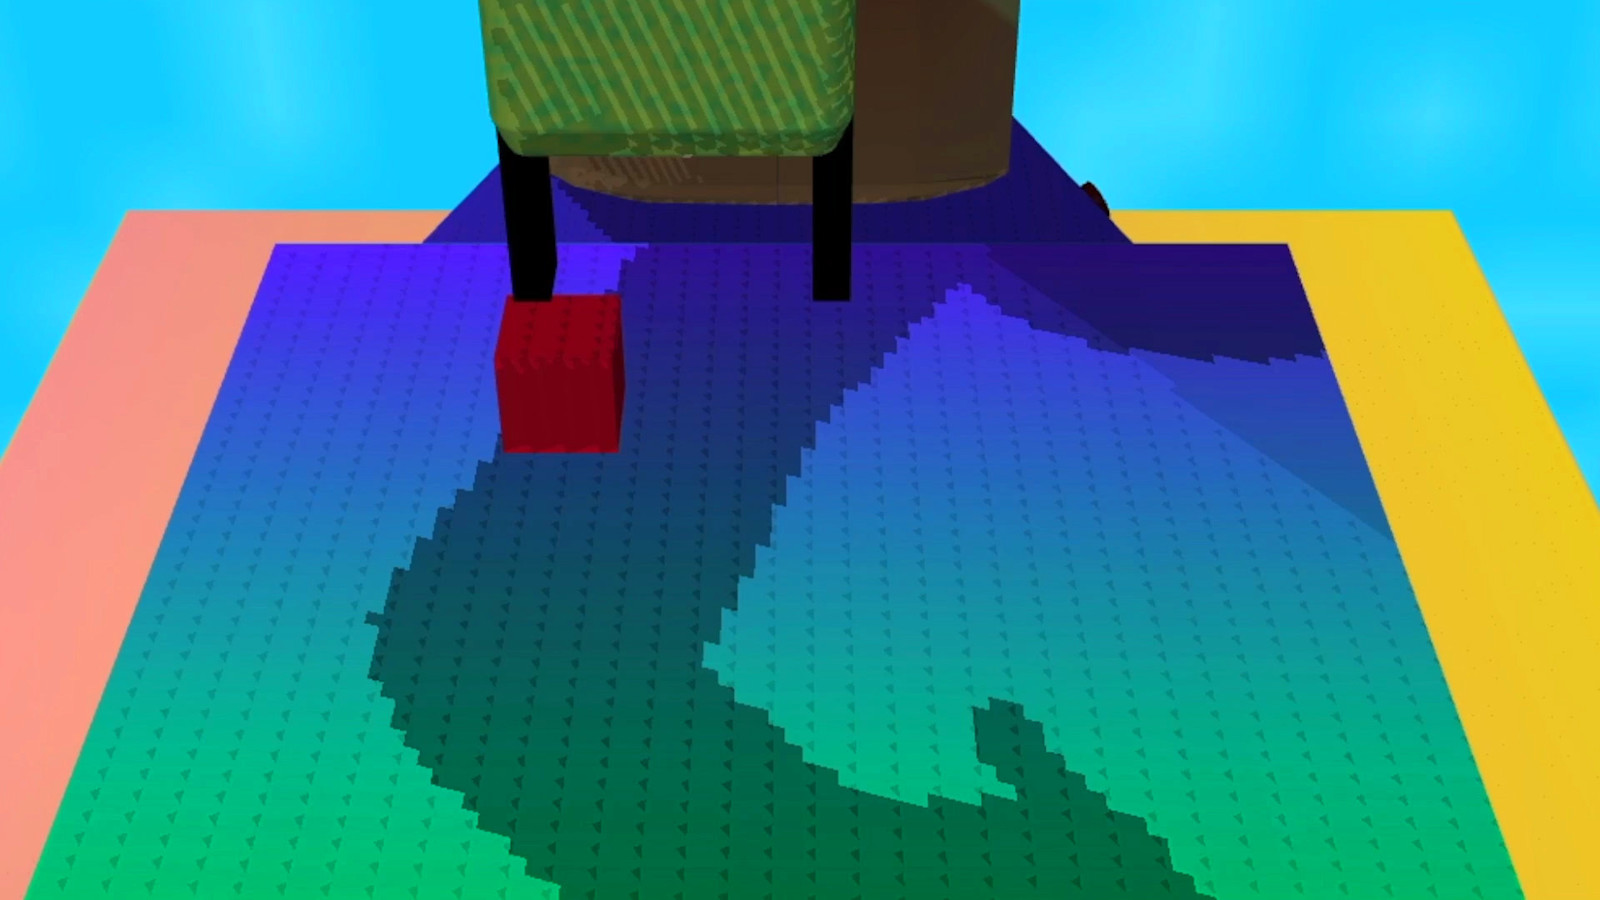
ผลลัพธ์จากหุ่นยนต์ในสภาพแวดล้อมจำลองอาจทำให้เข้าใจผิดว่า RL สามารถแก้ปัญหาหุ่นยนต์ได้เกือบทุกอย่าง แต่โดยทั่วไปแล้ว อัลกอริทึม RL จะทำงานได้ดีกับงานที่การเปลี่ยนแปลงเล็กน้อยของ Action ส่งผลต่อรางวัลอย่างต่อเนื่อง
สำหรับงานเช่นการวางบล็อก การกำหนดรางวัลที่ละเอียดนั้นซับซ้อนมาก แต่ทีมงานได้ใช้ HER ซึ่งช่วยให้ Agent สามารถเรียนรู้จากรางวัลแบบไบนารี โดยการสมมติว่าผลลัพธ์ที่เกิดขึ้นคือสิ่งที่พวกเขาต้องการเรียนรู้
นอกจากนี้ยังมีการใช้ Domain Randomization กับรูปร่างภาพเพื่อสร้างระบบการมองเห็นที่แข็งแกร่งสำหรับโลกจริง โดยการใช้งาน HER นี้ใช้เทคนิค actor-critic ที่มีข้อมูลไม่สมมาตร คือ Critic เข้าถึงสถานะทั้งหมดของ Simulator ในขณะที่ Actor เข้าถึงเพียงข้อมูล RGB และ depth เท่านั้น
ศัพท์ที่ควรรู้
- Reinforcement Learning (RL) – เป็นวิธีการเรียนรู้ที่ Agent ปรับพฤติกรรมเพื่อเพิ่มรางวัลสูงสุดในสภาพแวดล้อม
- Dense reward – คือการให้รางวัลที่ละเอียดและต่อเนื่อง ซึ่งทำให้ Agent เรียนรู้ได้ง่ายกว่ารางวัลแบบสำเร็จ/ไม่สำเร็จ
- Hindsight Experience Replay (HER) – เป็นอัลกอริทึมที่ช่วยให้ Agent สามารถเรียนรู้จากผลลัพธ์ที่ไม่สำเร็จ โดยการสมมติว่าความล้มเหลวนั้นคือเป้าหมายที่ตั้งใจไว้
- Domain Randomization – คือการสุ่มค่าในสภาพแวดล้อมจำลอง เช่น รูปร่างภาพ เพื่อให้ Agent ทนทานต่อความแตกต่างในโลกจริง
- Actor-Critic – เป็นเทคนิคที่ใช้ในการฝึก โดย Actor คือ Policy และ Critic คือเครือข่ายที่ประเมินมูลค่าของสถานะ
ที่มา: OpenAI