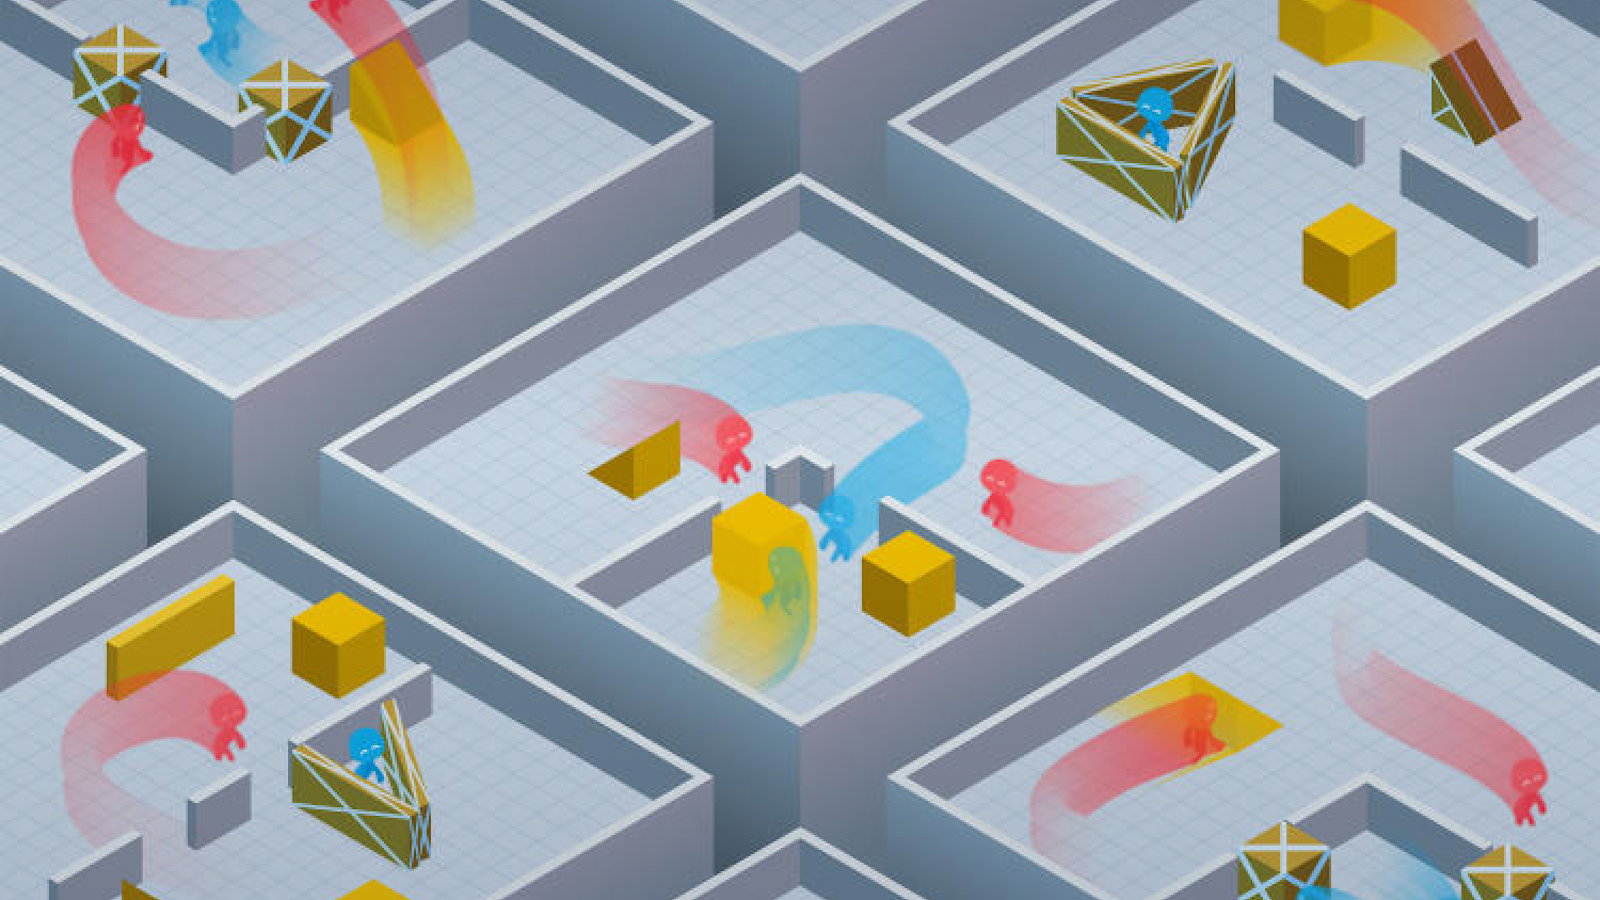
ในการฝึกเอเจนต์ซ่อนหา แต่ละวัตถุจะถูกฝังและส่งผ่านบล็อก self attention แบบ masked residual ซึ่งคล้ายกับที่ใช้ใน transformers แต่การให้ความสนใจจะอยู่ที่วัตถุแทนที่จะเป็นเวลา เราพบว่าการเพิ่ม batch size จะช่วยเร่งความเร็วในการบรรจบกันอย่างมาก แม้ว่าประสิทธิภาพในการสุ่มตัวอย่างจะไม่ได้เปลี่ยนแปลงมากนักเมื่อมีขนาด 32k ขึ้นไป
การเลือกการสร้างแบบจำลองหลักคือการกำหนดรูปแบบสถานะ เช่น ใน baseline แรก เราใส่เฉพาะตำแหน่งกล่องแบบ 2 มิติ ซึ่งกระตุ้นให้เอเจนต์ต้องโต้ตอบและเคลื่อนย้ายกล่องไปยังตำแหน่งใหม่ๆ
ตัวชี้วัดอย่าง ELO หรือ Trueskill สามารถวัดได้อย่างน่าเชื่อถือว่าประสิทธิภาพดีขึ้นเมื่อเทียบกับนโยบายก่อนหน้าหรือนโยบายอื่นในกลุ่ม แต่ตัวชี้วัดเหล่านี้ก็ยังไม่สามารถบอกได้ว่าประสิทธิภาพที่ดีขึ้นนั้นเกิดจากการปรับตัวใหม่หรือทักษะที่เรียนรู้มาก่อนหน้านั้น
การใช้สถิติเฉพาะของสภาพแวดล้อม เช่น การเคลื่อนที่ของวัตถุ ก็อาจมีความคลุมเครือได้เช่นกัน เช่น การเลือกติดตามการเคลื่อนที่สัมบูรณ์ไม่ได้ชี้ชัดว่าเอเจนต์เคลื่อนที่ไปในทิศทางใด
ศัพท์ที่ควรรู้
- Self attention – กลไกที่ช่วยให้โมเดลให้ความสำคัญกับส่วนต่างๆ ของข้อมูลที่ป้อนเข้าไป
- Transformers – สถาปัตยกรรมโครงข่ายประสาทเทียมที่ใช้ในการประมวลผลภาษาธรรมชาติ
- Batch size – ขนาดชุดข้อมูลที่ป้อนเข้าสู่โมเดลในแต่ละครั้งของการอัปเดต
- Convergence – จุดที่โมเดลเข้าสู่สถานะที่คงที่หรือการเรียนรู้สิ้นสุดลง
ที่มา: OpenAI