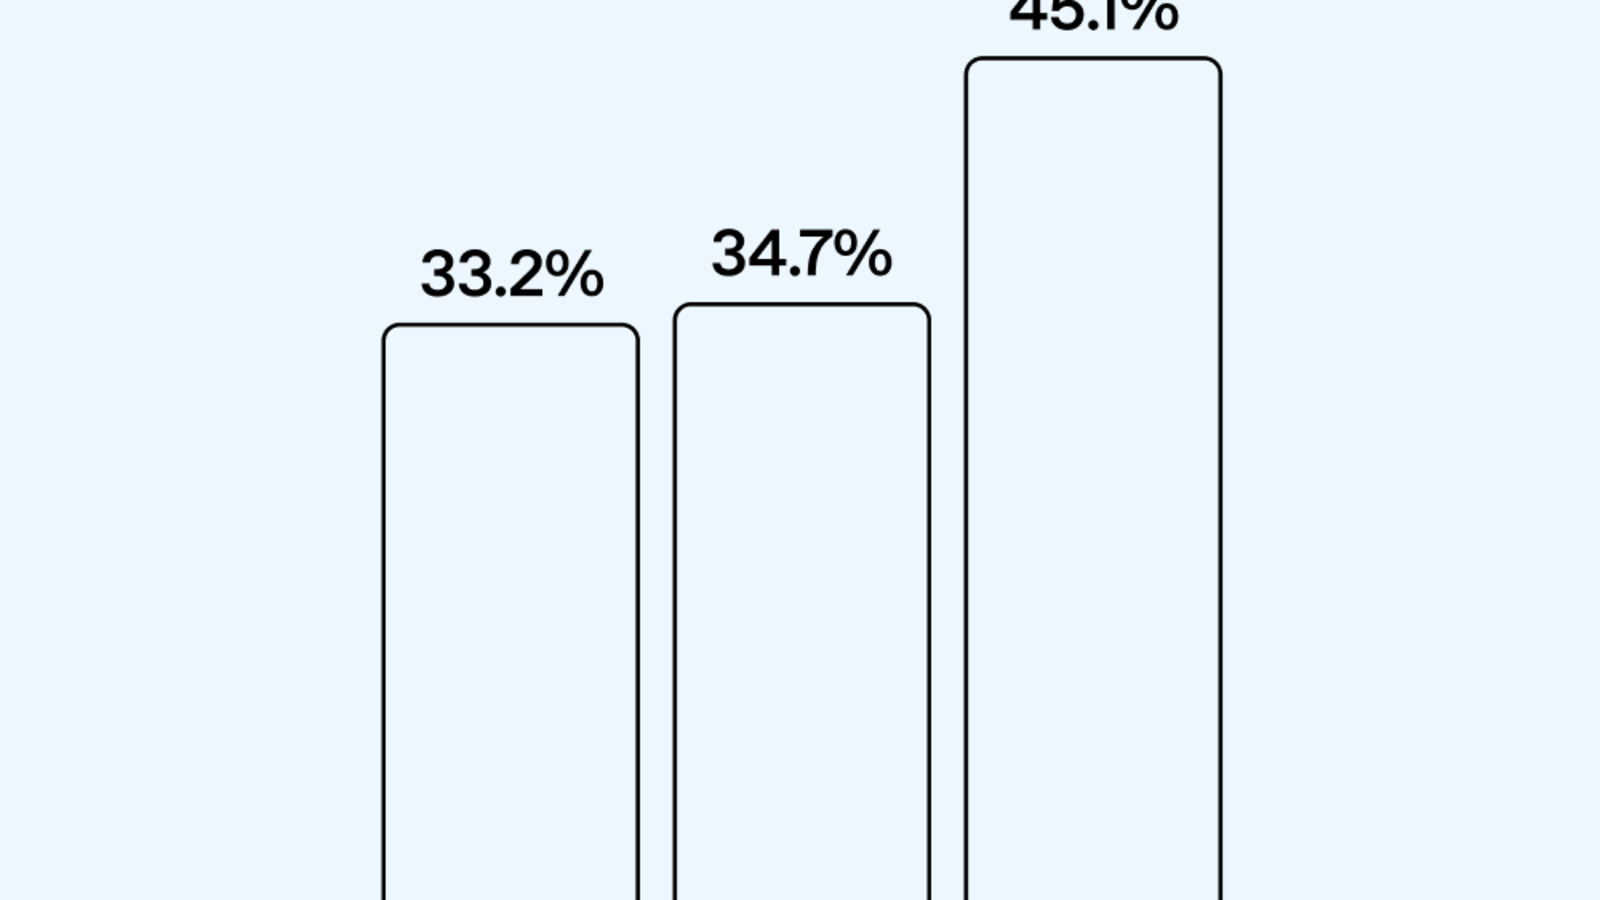
เราได้เปิดตัวชุดย่อยของ SWE-bench ที่ผ่านการตรวจสอบจากมนุษย์ ซึ่งสามารถประเมินความสามารถของโมเดล AI ในการแก้ไขปัญหาซอฟต์แวร์ในโลกแห่งความเป็นจริงได้อย่างแม่นยำมากขึ้น
เราได้ให้ข้อเสนอแนะโดยละเอียดแก่ผู้ตรวจสอบแต่ละคนตลอดกระบวนการเริ่มต้น เพื่อฝึกฝนพวกเขาสำหรับงานนี้ แม้ว่าผู้ตรวจสอบอาจจะไม่ใช่ผู้เชี่ยวชาญในโค้ดเบสที่เกี่ยวข้องกับ SWE-bench มาก่อน แต่พวกเขาก็ได้รับเวลาในการทำความคุ้นเคยกับโค้ดเบสแต่ละชุด
การตรวจสอบนี้ยกระดับระดับความเชี่ยวชาญและความใส่ใจที่จำเป็นในการคัดสรรและตรวจสอบเกณฑ์มาตรฐาน เพื่อให้แน่ใจว่ามีความท้าทายและแข็งแกร่งเพียงพอ ดังเช่นที่เห็นได้จากความแตกต่างของประสิทธิภาพของ GPT-4 บน SWE-bench Lite ที่แตกต่างกันระหว่าง 2.7% ถึง 28.3% ขึ้นอยู่กับวิธีการทดสอบ
ดังนั้น กรอบการเตรียมพร้อม (Preparedness Framework) จึงเรียกร้องให้มีการประเมินอย่างต่อเนื่องและบ่อยครั้งตามความจำเป็น เพื่อระบุการเปลี่ยนแปลงความสามารถที่ไม่ใช่เรื่องเล็กน้อย ซึ่งรวมถึงก่อน ระหว่าง และหลังการฝึกฝนด้วยซ้ำ
วิธีการของเรา
เราได้ให้ข้อเสนอแนะโดยละเอียดแก่ผู้ตรวจสอบแต่ละคนตลอดกระบวนการเริ่มต้น เพื่อฝึกฝนพวกเขาสำหรับงานนี้
ผู้ตรวจสอบไม่ได้จำเป็นต้องเป็นผู้เชี่ยวชาญในโค้ดเบสที่เกี่ยวข้องกับ SWE-bench ก่อน แต่พวกเขาได้รับเวลาในการทำความคุ้นเคยกับโค้ดเบสแต่ละชุด
การอภิปรายและข้อจำกัด
สิ่งนี้ยังยกระดับระดับความเชี่ยวชาญและความใส่ใจที่จำเป็นในการคัดสรรและตรวจสอบเกณฑ์มาตรฐาน เพื่อให้แน่ใจว่ามีความท้าทายและแข็งแกร่งเพียงพอ
เมื่อพิจารณาความแตกต่างระหว่างสคัลด์ที่ทำผลงานได้แย่ที่สุดและดีที่สุดสำหรับโมเดลใดๆ บน SWE-bench leaderboards เราจะเห็นว่าประสิทธิภาพของ GPT-4 บน SWE-bench Lite แตกต่างกันระหว่าง 2.7% โดยใช้สคัลด์แบบ RAG ในช่วงแรก และ 28.3% โดยใช้ CodeR
ดังนั้น กรอบการเตรียมพร้อมจึงเรียกร้องให้มีการประเมินอย่างต่อเนื่องและบ่อยครั้งตามความจำเป็น เพื่อระบุการเปลี่ยนแปลงความสามารถที่ไม่ใช่เรื่องเล็กน้อย ซึ่งรวมถึงก่อน ระหว่าง และหลังการฝึกฝนด้วยซ้ำ
ผู้เขียน
Neil Chowdhury, James Aung, Chan Jun Shern, Oliver Jaffe, Dane Sherburn, Giulio Starace, Evan Mays, Rachel Dias, Marwan Aljubeh, Mia Glaese, Carlos E.
คำขอบคุณ
เราขอขอบคุณ Carlos Jimenez, John Yang, Alexander Wettig, Shunyu Yao, Kexin Pei, Ofir Press และ Karthik Narasimhan สำหรับการพัฒนาเกณฑ์มาตรฐาน SWE-bench ดั้งเดิม ทีม Preparedness สำหรับการสนับสนุนงานนี้ Tao Lin ที่ชี้ให้เห็นปัญหาเหล่านี้ในตอนแรก Ian Kivlichan และ Sarah Schwettmann สำหรับข้อเสนอแนะเกี่ยวกับฉบับก่อน และผู้ตรวจสอบที่เป็นมนุษย์มากมายที่ช่วยสร้าง SWE-bench Verified
ศัพท์ที่ควรรู้
- SWE-bench – เกณฑ์มาตรฐานที่ใช้ประเมินความสามารถของโมเดล AI ในการแก้ไขปัญหาซอฟต์แวร์จริง
- Annotator – ผู้ตรวจสอบที่เป็นมนุษย์ที่ให้ข้อเสนอแนะและตรวจสอบความถูกต้องของเกณฑ์มาตรฐาน
- RAG-based scaffold – วิธีการทดสอบที่ใช้เทคนิค RAG (Retrieval-Augmented Generation) ในการช่วยประเมินผล
- GPT-4 – โมเดลภาษาขนาดใหญ่ที่ถูกนำมาทดสอบประสิทธิภาพบนเกณฑ์มาตรฐานนี้
ที่มา: OpenAI