
LinkedIn ได้นำ Apache Celeborn มาใช้เป็นแพลตฟอร์มสำหรับการทำ Remote Shuffle แบบส่วนกลางสำหรับงาน Apache Spark และ Apache Flink ส่วนใหญ่ โดยแยกการจัดเก็บข้อมูลกลางออกจากโครงสร้างพื้นฐานการประมวลผล
การปรับใช้ครั้งนี้ช่วยลดความล้มเหลวในการดึงข้อมูลรายวันจากประมาณ 750 ครั้ง เหลือเพียง 20 ครั้ง ลดต้นทุนการประมวลผลลง 10% และปรับปรุงเวลาการทำงานของแอปพลิเคชันได้ 14% เมื่อเทียบกับการใช้งาน Magnet เดิม
แพลตฟอร์มข้อมูลออฟไลน์ของ LinkedIn ประมวลผลงาน Spark มากกว่า 300,000 งานต่อวัน โดยใช้พลังการประมวลผลประมาณ 200 petabyte-hours
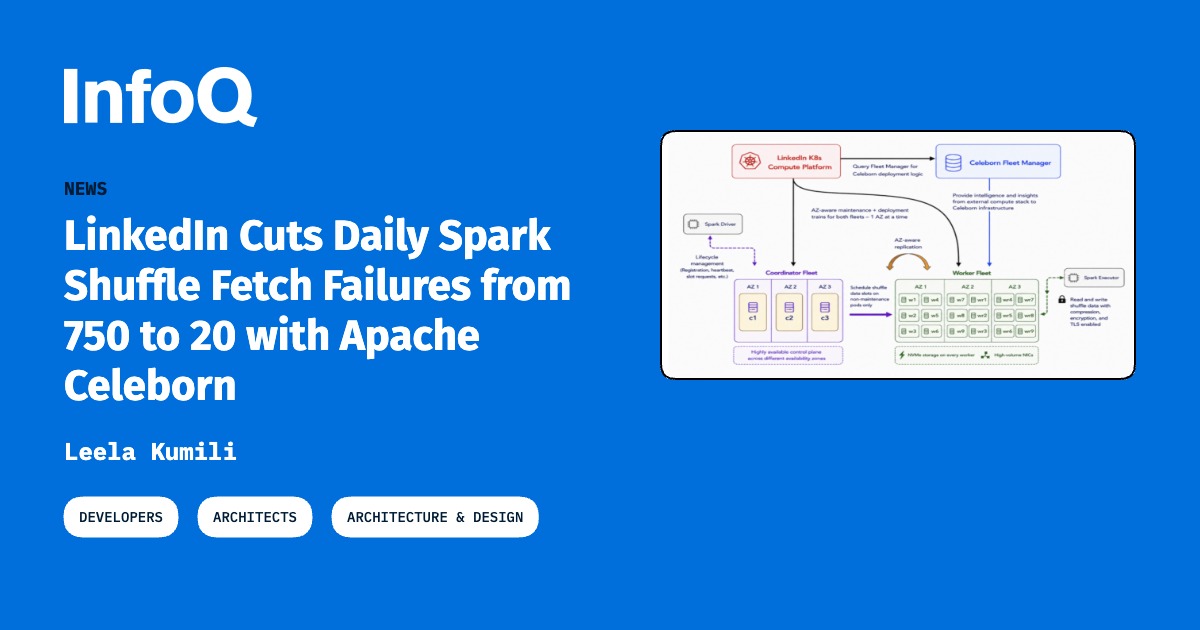
Celeborn ทำงานเป็นบริการ Shuffle แยกต่างหากพร้อมด้วย Worker เฉพาะและ Control Plane ที่จำลองขึ้น ซึ่งแตกต่างจาก Magnet ที่ใช้ Merger External Shuffle Services ภายในคลัสเตอร์ Spark
การปรับใช้ยังใช้ Control Plane แบบ Raft ที่มีห้าโหนด กระจายอยู่ใน Availability Zones และมีการนำเสนอการจำลองเครือข่าย (network-aware replication) เพื่อปรับปรุงประสิทธิภาพอย่างมาก
เมื่อรวมถึงการปรับปรุง JVM และ data-plane ทำให้ต้นทุน Shuffle ต่อ Task ลดลงเกือบ 90% และสัดส่วนของ Executor runtime ที่รอการทำงานของ Shuffle ลดลง 10–15%
นอกจากนี้ แพลตฟอร์ม Flink ที่รวมกันยังสามารถประมวลผลเหตุการณ์ได้หลายร้อยล้านเหตุการณ์ต่อชั่วโมง ทำให้งานที่ใช้เวลาหลายวันเสร็จสิ้นได้ภายในไม่กี่ชั่วโมง
ศัพท์ที่ควรรู้
- Apache Celeborn – เป็นแพลตฟอร์มที่ LinkedIn นำมาใช้เป็นบริการ Shuffle ระยะไกลสำหรับงานประมวลผลของตน
- Apache Spark – เป็นเฟรมเวิร์กสำหรับการประมวลผลข้อมูลขนาดใหญ่ที่ LinkedIn ใช้งานอยู่
- Apache Flink – เป็นแพลตฟอร์มที่ LinkedIn ใช้ในการประมวลผลข้อมูลแบบเรียลไทม์และย้อนหลัง
- Remote Shuffle – คือกระบวนการในการจัดเก็บและแลกเปลี่ยนข้อมูลกลางระหว่างขั้นตอนการประมวลผลของงาน Spark
- Raft-based control plane – คือระบบควบคุมที่ใช้กลไก Raft เพื่อให้เกิดความเสถียรและการกู้คืนระบบ
ที่มา: infoq.com