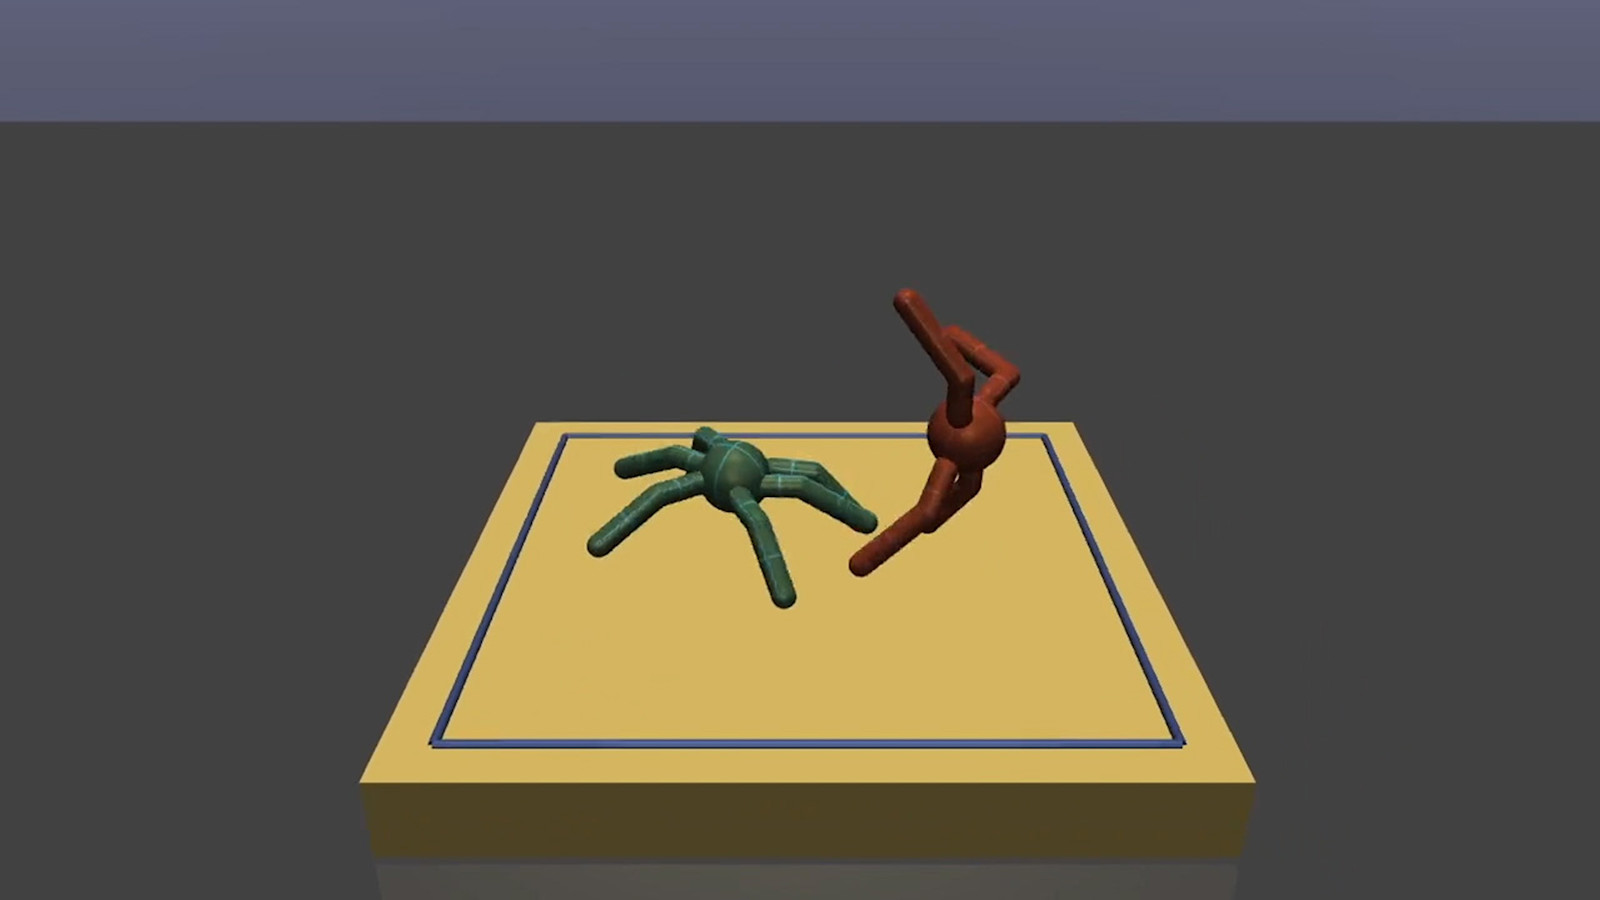
เพื่อทดสอบแนวทางการปรับตัวอย่างต่อเนื่อง เราได้ออกแบบเอเจนต์ 3 ประเภท ได้แก่ Ant (4 ขา), Bug (6 ขา) และ Spider (8 ขา) และจำลองการแข่งขันหลายรอบ โดยให้แต่ละเอเจนต์แข่งขันกับคู่ต่อสู้เดียวกัน และปรับพารามิเตอร์นโยบายระหว่างรอบเพื่อรับมือกับนโยบายของคู่ต่อสู้ให้ดียิ่งขึ้น
จากการทดสอบ พบว่าเอเจนต์ที่สามารถปรับกลยุทธ์ได้นั้นมีความสามารถในการแข่งขันสูงกว่าเอเจนต์ที่มีนโยบายคงที่มากนัก
หลังจากการฝึกฝนเอเจนต์กว่าร้อยตัว ซึ่งบางตัวเรียนรู้ที่จะคงที่และบางตัวเรียนรู้ที่จะปรับตัว เราได้ประเมินความเหมาะสมของแต่ละเอเจนต์
การเรียนรู้ระหว่างการปฏิบัติงานยังสามารถช่วยให้เอเจนต์รับมือกับการเปลี่ยนแปลงที่ไม่ปกติในร่างกายของตนเองได้ เช่น การปรับตัวเมื่อขาบางส่วนของตนเองเริ่มทำงานผิดปกติ ซึ่งชี้ให้เห็นว่าเทคนิคนี้สามารถนำไปใช้พัฒนาเอเจนต์ที่รับมือได้ทั้งการเปลี่ยนแปลงในสภาพแวดล้อมภายนอกและการเปลี่ยนแปลงทางกายภาพหรือสภาวะภายในของตนเอง
ศัพท์ที่ควรรู้
- Meta-learning – เป็นแนวทางการเรียนรู้ที่ช่วยให้เอเจนต์สามารถเรียนรู้วิธีการเรียนรู้ได้ด้วย
- Agent – ในบริบทนี้หมายถึงหุ่นยนต์จำลองที่ถูกฝึกฝนให้ตัดสินใจและแข่งขัน
- Policy – หมายถึงชุดของกลยุทธ์หรือกฎเกณฑ์ที่เอเจนต์ใช้ในการตัดสินใจในแต่ละสถานการณ์
- Ant, Bug, Spider – คือชื่อของเอเจนต์จำลองที่ถูกออกแบบโดยมีจำนวนขาแตกต่างกัน
ที่มา: OpenAI