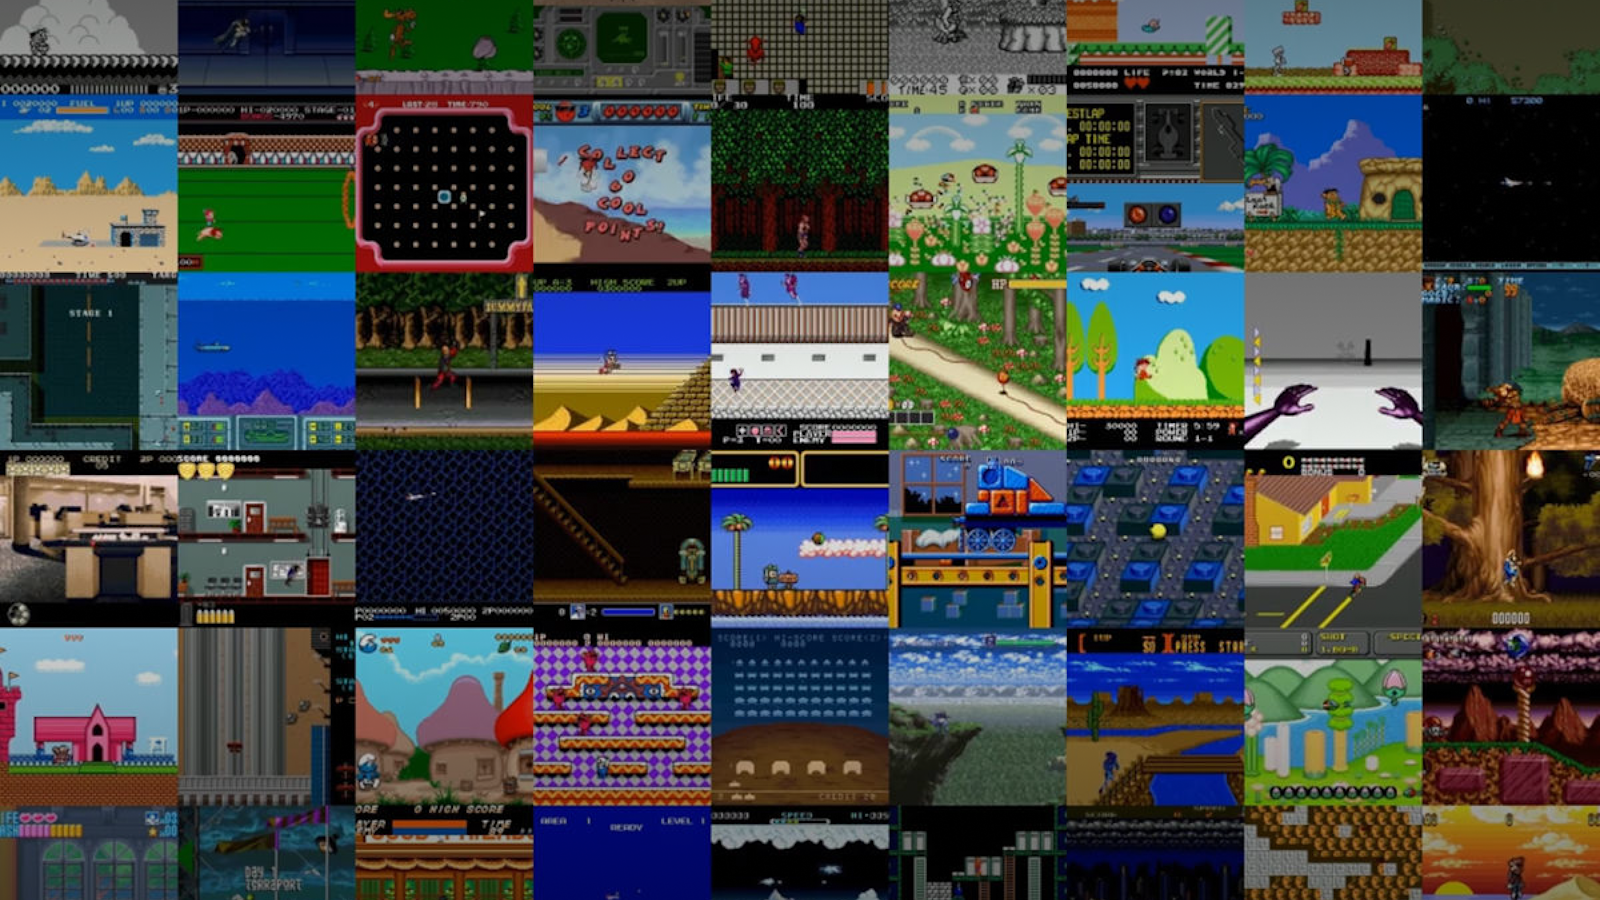
เราใช้ Gym Retro เพื่อทำการวิจัยเกี่ยวกับอัลกอริทึม RL และศึกษาเรื่องการสรุปองค์ความรู้ ในขณะที่งานวิจัย RL ก่อนหน้าส่วนใหญ่มุ่งเน้นไปที่การปรับปรุงเอเจนต์ให้แก้ปัญหาเดียวให้ได้
Gym Retro ช่วยให้เราสามารถศึกษาความสามารถในการสรุปองค์ความรู้ระหว่างเกมที่มีแนวคิดคล้ายกันแต่มีรูปลักษณ์แตกต่างกัน ชุดนี้มีการรวมเกมจาก Sega Genesis, Sega Master System, Nintendo NES, SNES และ Game Boy และยังมีการรองรับเบื้องต้นสำหรับ Sega Game Gear, Nintendo Game Boy Color, Nintendo Game Boy Advance และ NEC TurboGrafx ด้วย
การรวมเกมบางส่วนอยู่ในสถานะเบต้า และโค้ดจะยังคงอยู่บน branch เพื่อหลีกเลี่ยงการกระทบโค้ดของผู้เข้าแข่งขัน จนกว่าการแข่งขันจะสิ้นสุดลง
การแข่งขัน Retro Contest ที่กำลังดำเนินอยู่และรายงานทางเทคนิคของเราเน้นไปที่ปัญหาที่ง่ายกว่าคือการสรุปองค์ความรู้ระหว่างระดับต่างๆ ของเกมเดียวกัน แต่ Gym Retro เต็มรูปแบบนั้นทำให้การศึกษาปัญหาที่ยากกว่าคือการสรุปองค์ความรู้ระหว่างเกมที่แตกต่างกันอย่างแท้จริง
ศัพท์ที่ควรรู้
- RL (Reinforcement Learning) – คืออัลกอริทึมที่ช่วยให้เอเจนต์เรียนรู้การตัดสินใจที่ดีที่สุดผ่านการลองผิดลองถูก
- Generalization – คือความสามารถของเอเจนต์ในการนำสิ่งที่เรียนรู้จากสถานการณ์หนึ่งไปประยุกต์ใช้กับสถานการณ์ใหม่ที่คล้ายกัน
- Sega Genesis/Master System, Nintendo NES/SNES/Game Boy – คือชื่อคอนโซลเกมคลาสสิกที่ถูกนำมาจำลองในชุดข้อมูลนี้
- Branch – ในบริบทของโค้ด หมายถึงเส้นทางการพัฒนาโค้ดที่แยกออกมาจากโค้ดหลัก
ที่มา: OpenAI